📌 转载说明:本文首发于微信公众号《闫工的算力工具箱》 原文链接:https://mp.weixin.qq.com/s/tPX7MUdeQXIMQghmebrgGQ
【闫工的工具箱 · 第 18 弹|提效干货】#
上一篇把"日志怎么让 AI 替你看"从装到跑讲透了,今天再聊 3 个我每天都在用的 AI 工作流。这三个工作流,都是我在机房一点点磨出来的,每一个都有实打实的"以前 vs 现在"。
— — —
工作流 ①:网络设备改配置前,先让 AI 审一遍#
以前#
动生产网络的配置,第一步永远是 diff(示例):
# 把设备上的当前配置拉下来(思科设备)
ssh admin@10.1.1.1 "show running-config" > running-now.cfg
# 跟上一版备份对一遍
diff backup-20260901.cfg running-now.cfg
diff 只能告诉我哪一行变了,告诉不了我变了会怎么样。盯着几十行改动,得自己在脑子里过一遍:这条是不是计划内的?会不会断网?影响哪几台机器?一个变更窗口就那么点时间,漏看一条就出事。
拉配置的命令,思科和H3C/华为写法不一样。我现场大部分是H3C设备,直接从设备拉一份完整配置到本地:
# 关键在 screen-length disable,先禁掉分页,配置才一次吐完
ssh -tt admin@10.20.254.1 > config.cfg <<'EOF'
screen-length disable
display current-configuration
quit
EOF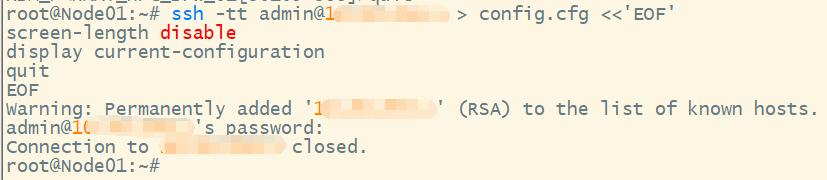
图:H3C/华为拉配置的真实命令——ssh -tt + here-doc,screen-length disable 写在最前面是核心
核心就一行——先关掉分页(screen-length disable),再吐配置,一次吐完不会卡住。思科对应的是terminal length 0,把display current-configuration换成show running-config就行。
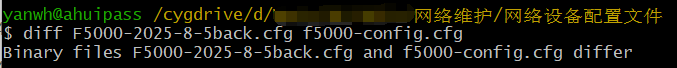
图:diff 提示 “Binary files … differ”——配置文件里夹了 SSH 提示符和控制字符,diff 不知道怎么处理
拉下来的文件开头可能带着SSH指纹提示,直接用diff会报Binary files differ。不要慌,加个-a就好:diff -a config-old.cfg config-new.cfg,让它按文本比,不用提前清理。
diff -a F5000-2025-8-5back.cfg f5000-config.cfg加完之后,同一份配置立刻能出 diff——sysname 改了哪个字、interface 加了哪条、ACL 顺序变了哪里,一目了然:
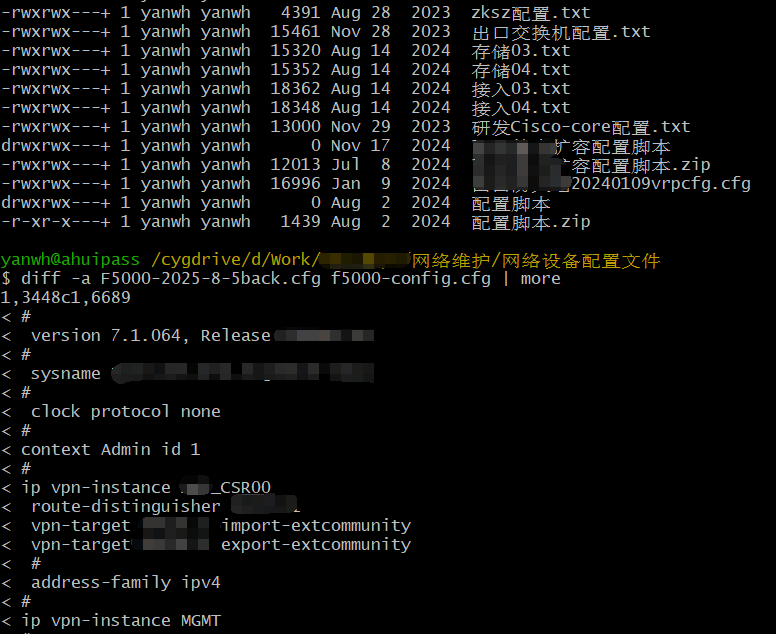
图:加 -a 后,diff 像正常文本比对一样逐屏把 H3C 配置 chunk 出来
现在#
两份配置一起丢给 AI,一句"这两份差在哪、有没有风险":
{ echo "=== 变更前 ==="; cat backup-20260901.cfg;
  echo "=== 变更后 ==="; cat running-now.cfg; } \
| ollama run qwen2.5:7b "这是同一台设备变更前后的两份配置。请回答:1. 逐条列出实际变更,用运维能看懂的话,别贴原始配置行 2. 标出哪些变更有断网或丢包风险 3. 给一条回滚时最该先恢复的项"输出(示意):
发现 4 处变更:
1. [高风险] VLAN 100 的 trunk 放行口被移除 Gi1/0/24,下挂 12 台 GPU 节点会断网
2. [中风险] OSPF cost 从 10 改成 40,流量改走备用路径,延迟可能上升
3. [低风险] SNMP community 字符串更新
4. [无风险] hostname 加了 -spine01 后缀

回滚要点:先恢复第 1 条,影响面最大。胜负手还是"喂背景",这个套路上一篇讲过。提问时补一段你们机房的实际情况,它的判断会准一大截:
【背景】Gi1/0/1-24 下挂 GPU 计算节点,VLAN 100 是训练网,断网会导致训练任务中断。不补这段,它只能看出"trunk 口被移除了";补上之后,它才知道这件事意味着 12 台机器上的训练要挂。
盯着 diff 看半小时?现在 4 行结论就够。它不会替你敲命令,但这堆改动里哪条会出事,它先替你过了一遍。
⚠️ 我自己的用法:结论先自己过一遍,再拿它扫一轮,看有没有漏掉的。最后拍板的永远是人,生产上动配置尤其如此。
— — —
工作流 ②:Excel 资产盘点#
以前#
几百行资产表格,手动对型号、对序列号、标异常:
- 拉公式对
Asset SN和BMC IP有没有重复; - 一个型号一个型号核对采购批次;
- 标异常、补缺失,拉公式拉到眼酸还怕漏。
现在#
整张表丢给 AI,一句"帮我对一遍":
# 把 CSV 丢给模型(Excel 先转 CSV,或者直接喂 xlsx)
python -c "
import pandas as pd
df = pd.read_excel('assets.xlsx')
print(df.to_csv(index=False))
" | ollama run qwen2.5:7b "帮我对一遍资产表:1. 找重复的SN/序列号 2. 找型号和位置不匹配的 3. 找缺失关键字段的行 4. 按机房分组统计数量"输出(示意):
检查结果:
1. 发现 2 处 SN 重复:A-1023(机房2)、B-0455(机房3)
2. 型号与位置不匹配:机房1 有一台标注 A800 实为 L20
3. 缺失字段:3 行缺 BMC IP,5 行缺采购日期
4. 统计:机房1 42 台 / 机房2 38 台 / 机房3 20 台
自动归类、找异常、补缺失,几分钟出干净结果。原来拉公式要 1 小时,现在看总结 5 分钟,省下的就是这 55 分钟。
— — —
工作流 ③:一键巡检#
以前#
巡检是人肉连环套:
ping -c 3 10.1.1.1            # 一条条 ping
df -h                               # 一行行看磁盘
sensors                           # 一个个查温度
ss -tlnp | grep :8080       # 一个个查端口
记到本子上,回来再整理成 Excel 表。100 台机器,一个晚上。
现在#
把这段脚本存成 one.sh 一键脚本(首行 #!/bin/bash 必须有,不然没法 ./one.sh 直接跑,只能 bash one.sh):
#!/bin/bash
# 一键巡检脚本:ips.txt 每行一个 IP
for ip in $(cat ips.txt); do
    ping -c 1 -W 2 $ip >/dev/null && ping_ok="OK" || ping_ok="FAIL"
    disk=$(ssh $ip "df -h / | awk 'NR==2{print \$5}'" 2>/dev/null)
    temp=$(ssh $ip "sensors | grep 'Package id' | awk '{print \$4}'" 2>/dev/null)
    port=$(ssh $ip "ss -tln | grep -c :8080" 2>/dev/null)
    echo "$ip | ping=$ping_ok | disk=$disk | temp=$temp | :8080=$port"
done | tee report.txt
记得 chmod +x one.sh 加执行权限,不然 ./one.sh 会被 bash 拒掉(Permission denied):
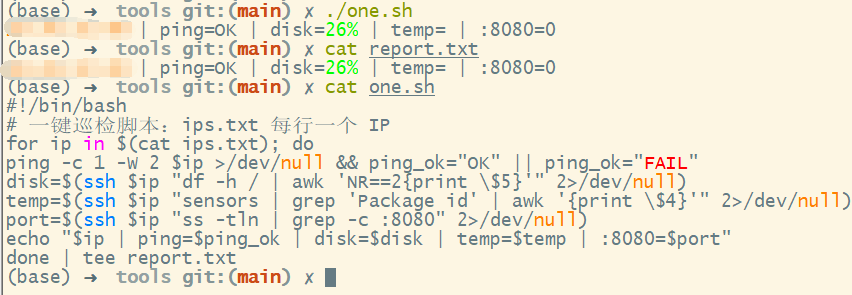
图: cat one.sh 脚本确认——ping/磁盘/温度/端口四件套,循环里 ssh 抓数据
跑完直接把 report.txt 丢给 AI 出体检报告:
cat report.txt | ollama run qwen2.5:7b "这是巡检结果,找出异常项:ping失败的、磁盘超80%的、温度超75度的,汇总成体检报告"输出(示意):
体检报告(100 台):
❌ 3 台 ping 不通:10.1.1.17 / 10.1.1.42 / 10.1.1.83 —— 需现场检查
⚠️ 2 台磁盘超 80%:10.1.1.5 (91%) / 10.1.1.9 (84%) —— 建议清理或扩容
⚠️ 1 台温度偏高:10.1.1.33 (78°C) —— 检查风扇和风道
✅ 其余 94 台正常
100 台机器一个晚上记笔记的活,现在一条命令 + 一份报告搞定。
— — —
END#
你平时最想"偷懒"的运维任务是什么?设备验收、日志排查,还是别的?评论区说说,一起学习交流下。