📌 转载说明:本文首发于微信公众号《闫工的算力工具箱》 原文链接:https://mp.weixin.qq.com/s/GgXaWzYpIWCA3mg-ydNfHA
【闫工的工具箱 · 第 16 弹|科普】#
先抛个反直觉的结论:L20 的峰值算力比 A800 还高,跑真实模型却慢整整一倍。 这就是"算力虚标"的真相——不是机器不行,而是"口径"不对。
做算力交付的同行,八成遇到过这种对话:
客户拿着官网标称的 TFLOPS 来验收,一实测就炸:“你这台 A800 是不是虚标?官网写 312,你怎么才测出 67?”
不是你机器有问题,是 TFLOPS 的"口径"太多,两边说岔了。今天把这笔账算清楚:TFLOPS 有几种算法、为啥差这么多、实测该看哪个数。
— — —
1. TFLOPS 是啥?先扫个盲#
TFLOPS = 每秒万亿次浮点运算(Tera FLoating-point Operations Per Second)。
但"浮点运算"有精度之分,位数越低、算得越快:
| 精度 | 含义 | 典型场景 |
|---|---|---|
| FP64 | 双精度 64 位 | 科学计算/仿真 |
| FP32 | 单精度 32 位 | 框架默认 |
| TF32 | 动态范围同 FP32、尾数同 FP16 | Ampere+ 矩阵计算默认 |
| FP16 | 半精度 16 位,易溢出 | 早期训练 |
| BF16 | 16 位但指数 8 位(同 FP32 范围) | 大模型训练首选 |
| FP8 | 8 位(Hopper+ 引入) | 推理标配、训练已验证 |
| INT8 | 8 位整数 | 推理量化 |
这里单独说下 TF32:它是 NVIDIA 从 Ampere 架构(A100/H100 这一代)开始引入的一种"折中"精度——指数位(决定能表示多大范围)沿用 FP32,尾数(决定计算精度)压缩到 FP16 水平。可以简单理解为:一种专为 AI 矩阵运算设计的精度格式,既保留了 FP32 不容易溢出的稳定范围,又拿到了 FP16 的计算效率,所以在 A100/H100 这类卡上,矩阵乘默认就用 TF32,不用你手动切。
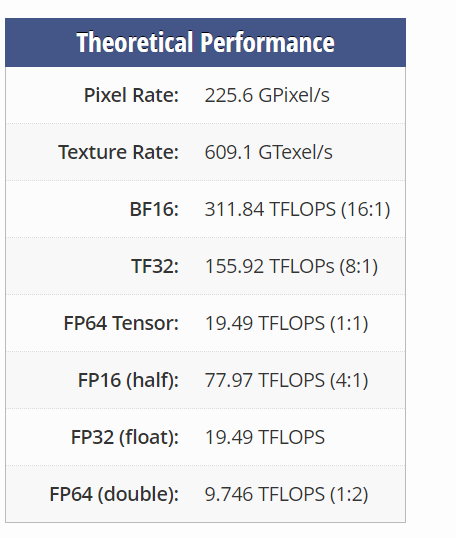
约减半位数,吞吐翻倍。同样是 A100,FP32 约 19.5 TFLOPS,FP16 Tensor 约 312 TFLOPS,差 16 倍,而它们都叫"A100 的 TFLOPS"。
2. 第一个坑:CUDA Core 和 Tensor Core 不是一回事#
GPU 里有两套算力单元:
- CUDA Cores:通用计算,处理激活函数、非矩阵运算,按 FP32 峰值衡量(A100 约 19.5 TFLOPS);
- Tensor Cores:专为矩阵乘加(MMA)设计的加速单元,只在 FP16/BF16/TF32/FP8 下生效,吞吐远高于 CUDA Cores(A100 FP16 Tensor 约 312 TFLOPS)。
神经网络的矩阵乘占算力需求 80%~90%,所以比较 AI 算力通常看 Tensor TFLOPS,它和 CUDA Core 的 FP32 能差一个数量级。
A800 标 312 是哪来的?就是 FP16/BF16 Tensor Core(Sparse)的标称值,最高规格、最理想工况。
3. 第二个坑:标称值用的是"稀疏"还是"稠密"?#
NVIDIA 标称 Tensor TFLOPS 通常给两个值:
- Dense(稠密):无稀疏加速,真实可用;
- Sparse(2:4 结构化稀疏):一半权重是 0,跳过计算,吞吐翻倍。
实际模型的权重大多不具备稀疏结构,对外口径必须用 Dense 值,Sparse 值只是上限参考。
4. 实测数据:同一批机器,差在哪?#
我们内部用 cudaTensorCoreGemm(张量核心 GEMM 样例,累加器 FP32,测的是 TF32)做了对比:
同机型 A800,不同驱动(CUDA 12.1):
| 项目 | 535.129.03 | 550.54.14 |
|---|---|---|
| cTCG | 1.93ms | 2.04ms |
| TFOPS | 71 | 67.24 |
| LLava | 921.55s | 921.3s |
结论:同款 GPU 换驱动,性能基本没差(误差范围内),驱动不是背锅侠。
A800 vs L20(驱动均为 550.54.14 / CUDA 12.1):
| 项目 | A800 | L20 |
|---|---|---|
| cTCG | 2.04ms | 1.87ms |
| TFOPS | 67.24 | 73.34 |
| LLava | 921.2s | 2150s |
| dit (Step/Sec) | 1.78 | 0.85 |
| chat-GLM (Step/Sec) | 1.782 | 0.819 |
有意思的是:
- 单看 cTCG 峰值,L20 反而比 A800 高(73 vs 67);
- 但跑真实模型,A800 比 L20 快约 2 倍(921s vs 2150s)。
这正好说明:峰值 TFLOPS 不等于真实训练吞吐。模型结构、I/O、通信开销,都会显著影响最终性能。所以验收时千万别拿标称峰值去估算实际训练速度——A800 标称 312,实测 TF32 只有 67;单看峰值 L20 还比 A800 高,真跑起来却慢一倍。
5. 交付必看:验收口径建议#
- 对外统一用 Dense Tensor TFLOPS,标注精度(TF32/FP16/BF16/FP8);
- 标称值 vs 实测值对不上时,先查口径:精度?Dense/Sparse?CUDA Core/Tensor Core?
- 验收压测用真实业务模型(LLava/dit/chat-GLM 这类),别只跑峰值样例;
- 记录版本:GPU 型号、驱动、CUDA、NCCL、框架版本,版本不同结果不同,可追溯才能复现;
- 直接引用未注明口径的 “TFLOPS” 极易引发客户误解,报价单上写清楚。
— — —
往期回顾#
ESXi系统盘重装后虚拟机消失?别慌,三步救回数据盘里的虚拟机
8卡变7卡、93°C还在Throttling:卡没坏,是热到"自我降速"了