📌 转载说明:本文首发于微信公众号《闫工的算力工具箱》 原文链接:https://mp.weixin.qq.com/s/pl_-FICLQ58lu2PAk9zwng
【闫工的工具箱 · 第 26 弹|算力交付】#
我是闫工,数据中心搬砖的 CCIE。
做交付久了,注意力都在"把机器装起来"这一头:上架、装系统、配网、压测、签字。直到上个月连着收到几张退订单,我才发现交付链路的另一头同样要命——机器退回来了,盘里的数据还在。
那张退订单我至今印象很深:明细里三行资产编码,只有一行的"退订标识"标了"是",另外两行全是"否"。流程上这行"是"就是信号:这台机器进回收,另外两台哪怕一根网线都不能随便碰。
当时我的第一反应是:关机、下架、重置一下不就能入池了?
幸好没这么干。
— — —
事情不难,但性质不一样#
装机的活干砸了,最坏的后果是交付延期:重装一遍,跟客户道个歉,最多赔点时间。
回收的活干砸了,后果是数据事故:客户训练了几个月的模型权重、核心业务数据、未公开的配置文件,跟着设备流到了下一个使用者手里。轻则赔钱,重则撞合规红线——等保、数据出境那套,不是道歉能解决的。
区别就在这儿:装机是可以补救的,数据泄露是不可逆的。
所以现在我看退订单的眼神,跟看装机单完全不一样。装机我敢并行、敢攒批;回收我一台一台盯,宁可慢。
📌 我们内部定的底线就一句话:没完成数据清理的设备,严禁重新入池,也严禁移出机房。 把出机房这一步卡死,是因为设备一旦脱离机房的物理管控,后面能做的补救就只剩"上门追设备"这一条路了。
— — —
五步走完,机器才能重新变回"待交付"#
这套流程我跑了几个批次之后基本定型了,画出来是这样:
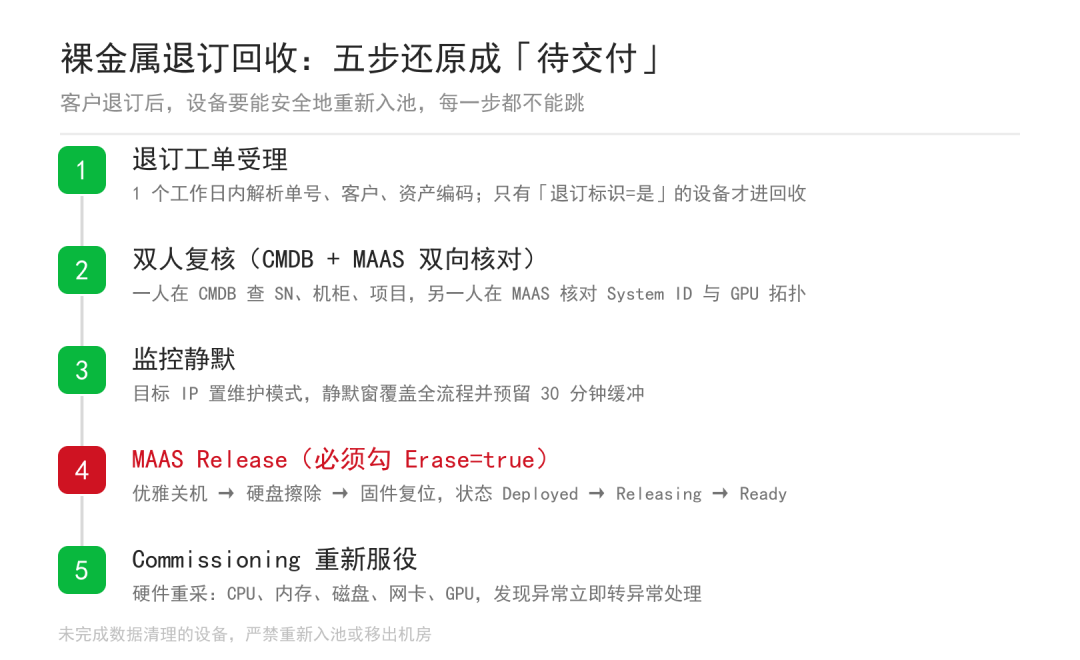
图:退订回收的完整链路,第 4 步的擦除是整个流程的核心
拆开说每一步在防什么。整套链路的重心是第 4 步的擦除动作,前面所有校验,都是为了确保这一步执行在正确的设备上。
第一步:工单受理(1 个工作日)#
收到退订单后先把关键字段解析出来:退订单号、客户名称、项目编号、资产编码、退订标识、生成单号。
退订标识这一列最容易被忽略。一张退订单里往往混着"退"和"不退"的设备:客户可能只是退掉一部分配置,或者按批次陆续退。所以筛选条件不是"工单里有几台就回收几台",而是只处理"退订标识=是"的行。
这一步漏了,后面做得再规范都是错的:你会把客户还在用的机器给卸了。
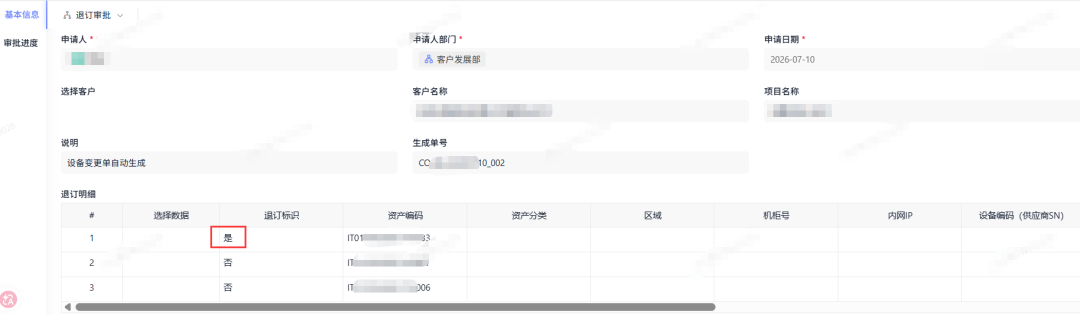
图:一张退订单的真实样子。红框那行的"退订标识=是"才是要回收的设备,下面两行标"否"的,一根线都不能碰
第二步:双人双系统复核#
一条退订单,两个人分别在不同系统里核对,谁都别想省事:
- 一人在 CMDB 里按资产编码查这台机器的 SN、机柜位置、所属项目;
- 另一人在 MAAS 里按 SN 或主机名定位节点,核对 System ID、CPU/内存/GPU 拓扑、所在资源池。
两边信息对不上就停下来,退回客户成功部门重新核。这一步听着像形式主义,但它是唯一能拦住"擦错机器"的环节:一个人看走眼还有第二个人兜,两个系统同时出错的概率就低得多。
第三步:监控静默#
把目标 IP 在监控平台上置为维护模式,静默窗口要把整个操作时段覆盖住,再往后留 30 分钟缓冲。
不留缓冲不行。回收过程里机器会关机、重启、掉线,监控系统如果不静默,告警会一条接一条地炸;等你收完尾,还得花时间跟值班同事解释"那些告警是我在拆机"。留 30 分钟是给状态收敛和收尾留的余量。
顺带说一句:VPC、弹性 IP、对象存储这些要在回收开始前就解绑完。这是网络组和存储组的活,别等你要 Release 了才发现资源还挂着。
第四步:MAAS Release(核心动作,必须勾擦除)#
这一步是整套流程的重心。在 MAAS 里对节点执行 Release,它内部按顺序做四件事:
优雅关机
通过 IPMI/BMC 发 ACPI 关机;
硬盘擦除
按存储模板和服役脚本执行;
固件复位
BMC、网卡恢复到出厂状态,清掉租户配置;
状态回退
Deployed → Releasing → Ready。
少量机器手动操作走 WebUI 就行:
登录 MAAS WebUI → Machines
搜索定位目标节点(SN 或主机名)
勾选 → Take action → Release
弹出框里确认勾选 "Erase disks"
点击 Release machine,观察状态 Deployed → Releasing → Ready
截图节点详情页存档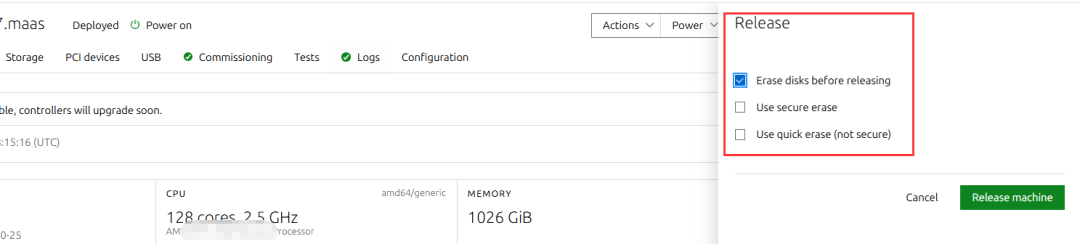
图:Release 弹窗里「Erase disks before releasing」必须勾上;安全等级高的场景,再把下面的 Secure erase 一并选上
批量或者要写进脚本的,走 API:
# 1) 取 system_id
maas <profile> machines read | jq -r '.[] | select(.hostname=="<主机名>") | .system_id'

# 2) 显式擦除释放
maas <profile> machine release <system_id> erase=true

# 3) 轮询至 Ready
maas <profile> machine read <system_id> | jq '.status_name'
erase=true 这个参数是必须显式带上的,并且要对勾选动作截图存档——后来有人问"这批到底擦没擦",你能拿出来的就是这张截图。
MAAS 侧的配置我是这么定的:
| 配置项 | 取值 | 说明 |
|---|---|---|
| Disk erasure | Enabled | 开启释放时自动擦除 |
| Erasure type | Secure erase(优先)/ Fast erase(备用) | 固件原生擦除优先 |
| Erase on release | 必须勾选 | 释放必触发擦除 |
| Default storage layout | Flat layout | 所有本地盘纳入管理 |
| Secure erase cycle | 1 次(默认);高敏 ≥2 次 | 高安全等级多轮擦除 |
第五步:Commissioning 重新服役#
Release 之后 MAAS 会重新跑一遍服役流程,把硬件信息重新采一遍:CPU、内存、磁盘(含 SMART)、网卡(MAC/Fabric/VLAN)、GPU、BMC 可达性、PXE 连通性。
这一步的作用是确认这台机器还能用。回收回来的设备不一定都健康,可能有盘报错、有卡掉过、有网口不通。自检发现异常就转异常处理流程,别让它带着问题上架,那等于把麻烦转移给了下一批客户。
— — —
“擦干净"到底怎么定义#
这一步我一开始也是糊的:以为把分区删掉、写一遍零就算完事。后来才理清,擦除是分级的,不同的数据敏感度对应不同的手段。
行业里最常被引用的基线是 NIST SP 800-88 Rev.1,它把介质清理分成三档:
| 档位 | 做法 | 适用 |
|---|---|---|
| Clear | 覆写或固件级别的擦除,防软件级恢复 | 常规业务数据、设备内部流转 |
| Purge | 更强的擦除(如 NVMe Sanitize、加密擦除),防实验室级恢复 | 敏感数据、要出机房的设备 |
| Destroy | 物理销毁:盘体粉碎或消磁 | 报废介质、无法固件擦除的盘 |
落到具体命令上,能选固件原生的就别用软件覆写:
ATA Secure Erase / NVMe Sanitize
——直接调磁盘固件里的安全擦除指令,效率和彻底性都优于软件一遍遍写零;
DoD 5220.22-M
——多轮覆写标准(比如 3 次覆写),适合高敏的磁介质;
物理销毁
——盘已经报废、或者固件擦除指令不支持的,直接粉碎/消磁,但要记录销毁时间、执行人、介质 SN,留存销毁凭证。
对含 AI 模型权重、金融风控数据、商业秘密源码这类高敏场景,我在 MAAS 默认擦除之后再追一轮随机覆写。做法是往 MAAS 的服役脚本目录塞一个定制脚本:
#!/bin/bash
# 高敏场景:MAAS 默认擦除后额外一轮 urandom 覆写(排除引导盘)
set -e
for disk in $(lsblk -d -n -o NAME,TYPE | awk '$2=="disk"{print $1}'); do
    if mount | grep -q "/dev/${disk}\b"; then continue; fi
    dd if=/dev/urandom of=/dev/${disk} bs=1M status=progress conv=fsync || true
    sync
done
脚本放 /usr/local/maas/commissioning-scripts/99-extra-wipe,权限 0750、属主 maas,上线前要过一遍同行评审。
⚠️ 我自己吃过一次实打实的教训:这种带
dd的脚本,测试环境跑通不等于生产能跑。第一次上线我漏了mount那行判断,脚本差点把还在挂载的业务盘一起写掉。后来才定死规矩:任何自动擦除脚本,先确认排除逻辑完全正确,再小范围试一台验证没问题,才能批量上线。
— — —
怎么确认"真的擦干净了”#
擦除动作执行完,不等于数据真的没了。我会按这张表逐项过一遍:
| 验证项 | 怎么验 | 通过标准 |
|---|---|---|
| 节点状态 | MAAS Machines 列表 | Ready(绿色) |
| 存储清空 | Storage 页面 | 所有磁盘 Available,看不到分区信息 |
| 电源状态 | Power 字段 | Power off |
| 硬件信息 | Commissioning 输出 | CPU/内存/GPU/网卡已重采 |
| 固件复位 | BMC / 网卡配置比对 | 恢复出厂,无租户配置 |
| PXE 连通 | Rack Controller 状态 | 能正常 PXE 引导并被纳管 |
| NVMe 擦除 | nvme sanitize-log /dev/nvme0n1 | SSTAT=0x101,SPROG=65535 |
最后那行是硬证据。nvme sanitize-log 里的这两个字段能直接说明固件擦除跑没跑完、跑到哪一步——比"我看它执行完了"可靠得多。
— — —
我踩过的几个坑#
Release 卡在 Releasing 不动,超过 30 分钟还没到 Ready。第一反应是 MAAS 出问题了,实际去查 Rack Controller 日志,发现是 PXE 侧不通——机器已经进入擦除流程,但拿不到引导。处理办法是先恢复 PXE 连通性,再重新触发 Release。
NVMe 报 Security 冻结,擦除指令直接被拒。原因是盘之前被别的工具占用过,安全状态没释放。这时候常规命令推不动,得经 BMC 挂一个救援镜像进去,手动执行 nvme format / nvme sanitize,完事再重新 Commission。
擦完还有旧分区残留。查下来是存储模板没覆盖到位,MAAS 只处理了模板里定义的盘。补上模板、必要时 wipefs -a 清残,再重新走一遍服役。
回收完 GPU 健康检查不过。这台机器掉过卡、ECC 有计数,自检直接判不通过。处理是换卡或者整机送修,同时把资产状态同步到 CMDB——不能让一台有问题的机器挂在"可用"状态里。
📌 还有个升级上报的口径要提前定好:单次失败导致 ≥5 台无法交付、涉及数据合规风险、24 小时内同一异常出现 ≥3 次、机房断电或网络隔离——这几种情况 30 分钟内上报,别自己扛。
— — —
这套流程的核心价值#
底线卡死
数据没清完不入池、不出机房。这条一破,后面所有流程都白搭
筛选先行
只看"退订标识=是"的行,避免误伤客户还在用的机器
双人双系统
CMDB 和 MAAS 互相印证,单点看走眼不会造成误擦
擦除分级
按数据敏感度选 Clear / Purge / Destroy,不搞"一刀切写零"
验证有硬证据
nvme sanitize-log的状态字段,比口头确认可靠全程留痕
勾选截图、Release 日志、Commissioning 报告都归档,事后能查
— — —