📌 转载说明:本文首发于微信公众号《闫工的算力工具箱》 原文链接:https://mp.weixin.qq.com/s/6p2X3tvbkUIj_evCEWfQFQ
测试对象:利旧(退役 / 拆机 / 库存回收)的 400G AOC 线缆 / MPO 光纤跳线 + QSFPDD 光模块 测试码型:PRBS-31Q(Media-side 硬件 PRBS),正反双向各 4 小时 测试环境:H3C S9825-64D · Comware V9.1.043, Release 9130(该机型软件自带 Media-side PRBS 功能;换用其他支持该功能的交换平台,命令需相应调整) 规模:2 Spine + 4 Leaf = 6 台交换机,128 根线缆/批 本文覆盖:测试原理、判定标准、前置准备、脚本执行、结果解读与排错
— — —
概述#
前阵子从退役机柜里拆出来一批 400G AOC 线缆和 QSFPDD 模块,外观完好、插上端口也能 up。但利旧件和新到货件最大的区别是——它没有质保,也没有可追溯的使用历史。这根线经历过多少次插拔、被弯折过什么角度、拆下来之前在什么负载下工作过,全都无从查证。
400G 由 8 条 50G PAM4 通道(Lane)并行组成,单条 Lane 出现虚焊、错位或光衰,不会阻止端口协商成功。端口照样 up,业务照样跑,只是那一路在持续消耗 FEC 的纠错余量。日常流量有 FEC(前向纠错)兜底,轻微误码被静默修正,应用层没有感知;等 FEC 修不动时故障才集中暴露,通常发生在训练任务跑到关键节点的深夜。
所以要绕开上层协议,直接看物理层。这套方案用 PRBS-31Q 硬件码型直测物理层,在 4 小时内暴露线缆与模块的余量问题;通过 forward + reverse 双向各 4 小时覆盖 AOC 两端的 TX/RX 独立通道,让旧件的隐性损伤无处可藏。
如果你手头也有利旧线缆要复用,这篇文章仅作研究参考——先知道什么算合格,再看怎么测(判定标准见下一章)。
— — —
一、判定标准#
1.1 PASS / WARNING / FAIL 三档#
结果按最差指标决定:4 小时压测中任一指标触碰 FAIL,整根线缆判定 FAIL。同一根线在两个方向上取更差的一次作为最终结论。
| 检查项 | PASS | WARNING | FAIL |
|---|---|---|---|
| 告警(LOL 失锁) | 无 | — | 存在任何 LOL |
| RX 光功率 | > -8 dBm | -10 ~ -8 dBm | ≤ -10 dBm |
| RX 光功率波动 | < ±1.5 dBm | ±1.5 ~ ±3.0 dBm | > ±3.0 dBm |
| 当前 BER | < 1E-12 | 1E-12 ~ 1E-10 | > 1E-10 |
| eSNR | > 22 dB | 18 ~ 22 dB | ≤ 18 dB |
| 温度变化 | < ±5°C | ±5 ~ ±8°C | > ±8°C |
| TX 光功率波动 | < ±1.5 dBm | ±1.5 ~ ±3.0 dBm | > ±3.0 dBm |
三档怎么处置:
| 判定 | 处置 |
|---|---|
| PASS | 通过,可进入复用清单 |
| WARNING | 单项指标接近临界,可限于非关键业务,建议缩短复检周期 |
| FAIL | 淘汰,不得上架 |
1.2 阈值为什么比手册宽#
初版脚本把光功率波动 FAIL 阈值设为 ±1.0 dBm,结果 4 小时压测中大量正常线缆的光功率抖动达到 1~2.x dBm,被误判为 FAIL——一度怀疑这批利旧件整体都有问题。
实测数据表明,400G 光模块在 4 小时连续压测下的光功率波动本就大于手册给出的理论健康值。阈值调整后:
| 指标 | 原阈值(FAIL) | 调整后 FAIL | 调整后 WARN |
|---|---|---|---|
| RX 光功率波动 | ±1.0 dBm | ±3.0 dBm | ±1.5 dBm |
| 温度变化 | — | ±8°C | ±5°C |
调整后重跑,误杀清零:128 端口实测中 FAIL 全部对应真实物理故障。
💡 阈值的经验:压测阈值应当用真机数据校准,不能照抄手册。手册给的是理论健康值,实测波动大于理论值是常态。文中的阈值来自 H3C S9825-64D 上跑出的实测数据,其他平台需要重新校准再定档。
— — —
二、原理与背景#
2.1 利旧件的典型隐患#
利旧线缆与模块的损伤分两类:一类能通过外观初检筛掉,一类必须靠压测才能暴露。
外观初检可识别:
| 检查项 | 典型问题 |
|---|---|
| 连接器端面 | 划伤、污染、研磨层磨损(多次插拔的累积损伤) |
| 卡扣与锁止结构 | 卡扣断裂、卡止力不足(插不紧或运行中脱出) |
| 外皮与应力释放 | 外皮开裂、应力释放套松脱、过度弯折痕迹 |
| 标签与追溯 | 标签丢失或字迹模糊,导致来源与使用批次不可追溯 |
必须靠压测暴露:
| 隐患类型 | 成因 | 压测中的表现 |
|---|---|---|
| 激光器老化 | 模块累计通电时长过长,发光效率衰减 | RX 光功率偏低、波动偏大 |
| 单 Lane 劣化 | 内部焊点或耦合结构受应力后接触不良 | 该 Lane BER 偏高,或直接 LOL 失锁 |
| 端面微损伤 | 肉眼不可见的研磨层磨损 | eSNR 偏低,误码率贴近门限 |
| 温漂敏感性上升 | 长期使用后器件对温度变化更敏感 | 温度波动时相关指标同步恶化 |
📌 结论:利旧件不能只做外观检查就上架。外观合格只能说明"看起来没问题",压测数据才能说明"性能余量还剩多少"。
2.2 为什么不能只看"灯亮"#
| 观测方式 | 能发现的问题 | 发现不了的问题 |
|---|---|---|
| 端口 up / 速率协商 | 链路完全不通、速率不匹配 | 单 Lane 劣化、光衰余量不足 |
| 业务流量跑通 | 应用层可见的连通性 | 被 FEC 修正的误码 |
| PRBS 压测 | 物理层误码、Lane 级劣化、光功率漂移 | — |
FEC 的纠错能力是有限的:当误码率接近 FEC 门限,链路会处于"能跑但脆弱"的状态,环境温度、机柜振动、端面污染任一变化都可能把它推过阈值。
2.3 PRBS-31Q 与 8 Lane 结构#
PRBS(伪随机二进制序列)是专用于高速链路误码性能测试的码型。本方案使用 PRBS-31Q(Media-side 硬件码型),序列长度 2³¹−1,约 21 亿 bit 周期,是商用模块可用的最严酷码型之一。
| 特性 | 说明 |
|---|---|
| 瞬态误码检出强 | 码型足够长,偶发误码难以逃逸 |
| 绕过上层协议 | 不依赖业务报文,链路物理 up 即可测,直接暴露物理层问题 |
| 8 Lane 独立 | 400G = 8 × 50G PAM4,每 Lane 独立发送比对,定位到具体通道 |
测试信号流:发送端 ASIC → Media Generator 注入 PRBS-31Q → 光模块 TX → 8 Lane 并行 → 对端光模块 RX → Media Checker 比对 → 返回 BER / eSNR 读数。
2.4 为什么必须双向各跑 4 小时#
一根 AOC 线缆两端各有独立的发射与接收电路,单方向只验证了线缆一半的物理路径(一端 TX → 另一端 RX)。利旧件的方向性损伤很常见——某一端连接器在拆卸过程中受过力、接口内针脚磨损程度不同——这类问题只在反向测试中才会暴露。
| 方向 | 发送端(generator) | 接收比对端(checker) |
|---|---|---|
| forward | Spine | Leaf |
| reverse | Leaf | Spine |
⚠️ 采集端必须跟随方向翻转:BER / LOL 只在 checker(接收比对)端有读数。reverse 方向时 checker 是 Spine,若脚本仍从 Leaf 采集,取到的是 generator 端数据,全程为空。
— — —
三、规划与准备#
3.1 测试床拓扑#
利用现网 Spine-Leaf 架构作为测试床,一批可测 128 根线缆(4 Leaf × 16 端口):
| 角色 | 设备名 | 管理 IP(示例) | 测试角色 |
|---|---|---|---|
| Spine01 | SPINE01 | 10.0.0.1 | 发送端组 1 |
| Spine02 | SPINE02 | 10.0.0.2 | 发送端组 2 |
| Leaf01~04 | LEAF01~04 | 10.0.0.11~14 | 接收端组 1~4 |
端口映射:Spine01 的 1/0/164 对应 Leaf0104 的 1/0/116;Spine02 的 1/0/164 对应 Leaf0104 的 1/0/1732。单批共 128 根线缆。
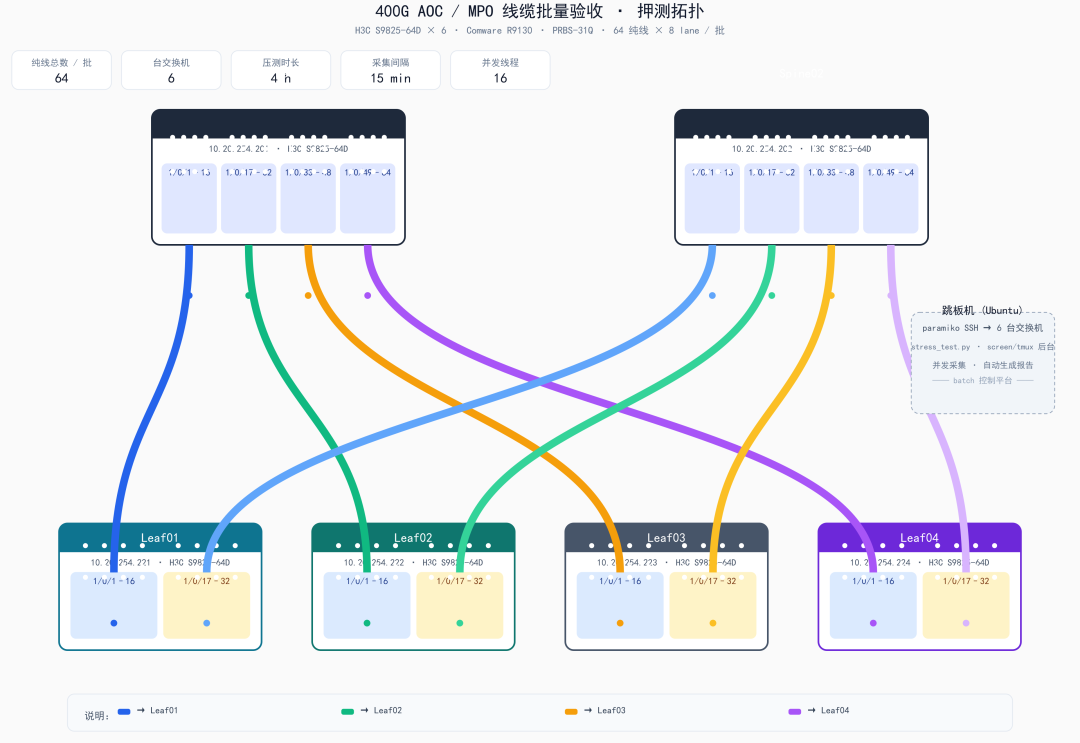
图:Spine 用全 64 口 400G,每台 Leaf 用 32 口接收两个方向;8 束 MPO AOC 跨接,配色与右下角目标 Leaf 对应
单批覆盖范围:128 根线缆 × 2 个方向 = 256 条测试链路,每方向 4 小时,合计 8 小时(含预热与报告生成约 8.5 小时)。
3.2 硬件准备#
| 项目 | 检查要点 |
|---|---|
| 来源清点与外观初检 | 记录每根线的回收来源与设备编号;外皮开裂、卡扣断裂、端面明显划伤的直接淘汰,不进压测 |
| 待测线缆/模块 | 按 128 根/批分组,两端贴同编号标签(如 Cable-001),便于 FAIL 定位 |
| MPO 端面清洁 | 使用专用 MPO 清洁笔(cletop)清洁所有端面 |
| 交换机端口 | 确认端口无物理损伤、无灰尘 |
| 线缆插接到位 | 插入时听到"咔哒"声才算到位 |
3.3 环境与依赖#
# 跳板机连通性验证(6 台交换机)
for ip in 10.0.0.1 10.0.0.2 10.0.0.11 10.0.0.12 10.0.0.13 10.0.0.14; do
    ping -c 2 $ip && echo "OK $ip" || echo "FAIL $ip"
done
# Python 依赖
sudo apt install -y python3-venv
python3 -m venv ~/400g_test/venv
source ~/400g_test/venv/bin/activate
pip install paramiko
# 验证 SSH 可登录(返回 Release 字样即成功)
for ip in 10.0.0.1 10.0.0.2 10.0.0.11 10.0.0.12 10.0.0.13 10.0.0.14; do
ssh -o ConnectTimeout=5 admin@$ip "display version | include Release"
done
# 确认光模块已上电、8 Lane 全部 Activated
display transceiver status interface FourHundredGigE 1/0/11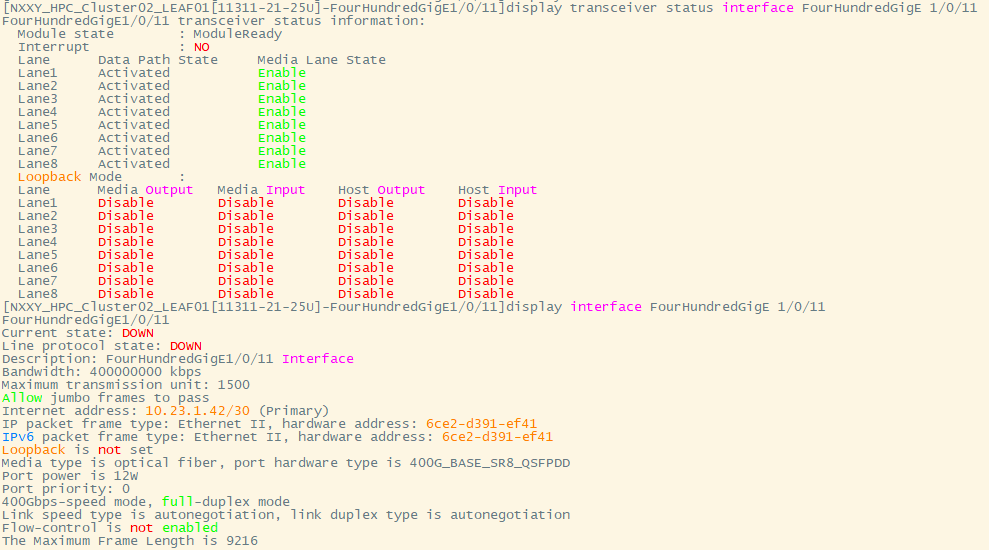
图:display transceiver status 实测输出,8 个 Lane 全部 Activated,可进入下一步配置
📌 未配置 PRBS 前,光模块的 Media Output / Media Input 显示 Disable 属正常状态;配置 PRBS 后 Media 端才会变为 Enable。
— — —
四、实施步骤#
4.1 脚本组成#
测试由两个文件构成,部署在跳板机上,通过 SSH 自动控制 6 台交换机:
| 文件 | 职责 |
|---|---|
config.py | 交换机地址与账号、端口映射、测试时长、判定阈值 |
str.py | 主逻辑:长连接管理、并发采集、报告生成,支持 --direction forward/reverse |
关键实现点:
- 使用
transceiver lane pattern media-generator/media-checker PRBS-31Q一条命令配置全部 8 Lane; - SSH 会话全程复用,自动处理
--More--分页与Continue?二次确认; - 配置后用
display this回读确认,避免"命令已下发但未生效"的假阳性; - 每 15 分钟采集一次诊断、告警、BER、eSNR。
4.2 执行流程#
# 进入工作目录,清理 Python 缓存
cd ~/400g_test && rm -rf __pycache__ && source venv/bin/activate

# 替换 config.py 中的占位密码
sed -i "s/your_password/<实际密码>/g" config.py

# 挂 screen 防止 SSH 断连中断测试(8 小时任务必须)
screen -S stress_test

# 正方向:Spine 发 / Leaf 收,4 小时
python3 str.py --debug

# 正方向跑完,同一会话内直接起反方向:Leaf 发 / Spine 收,再 4 小时
python3 str.py --direction reverse --debug

# Ctrl+A 然后 D 退出但不杀进程;重连:screen -r stress_test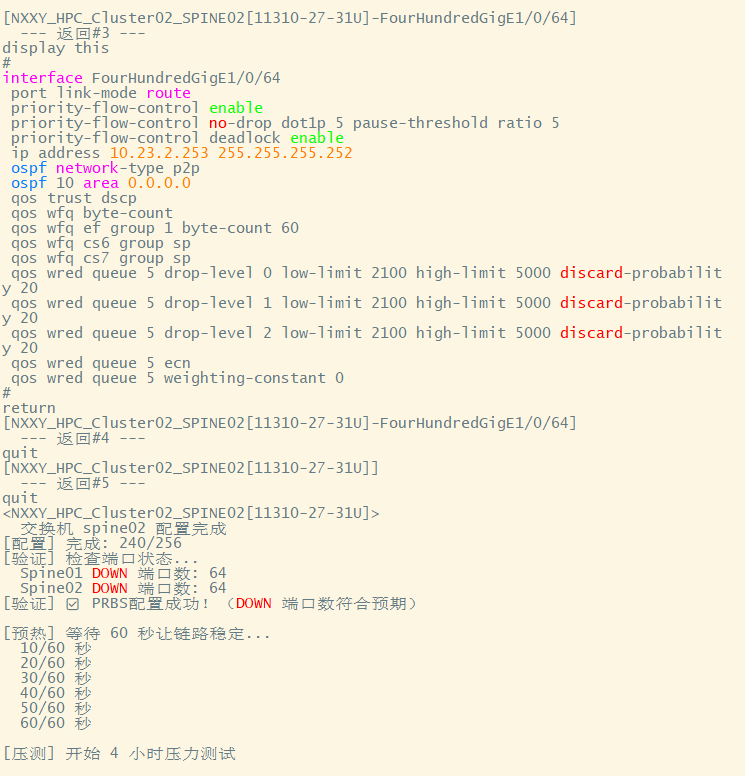
图:实测启动日志。6 台交换机 256 端口配置完成,Spine01/02 DOWN 端口数各 64,随后进入 4 小时压测
⚠️ rm -rf __pycache__ 是必须的:from config import * 会把旧阈值与端口映射缓存进 config.cpython-*.pyc,改完配置不清缓存,脚本仍按旧参数运行。
📌 测试期间不要拔插线缆:会影响链路状态与测试结果。正方向跑完后保持接线不动,直接以 --direction reverse 续跑。
4.3 预热与采集节奏#
| 阶段 | 时长 | 操作 |
|---|---|---|
| 预热 | 60 秒 | PRBS 信号建立、链路稳定 |
| 基线采集 | 1 分钟 | 采集初始诊断数据 |
| 持续压测 | 4 小时 | 每 15 分钟采集一次(共 16 轮) |
| 最终采集 | 1 分钟 | 采集结束数据 |
| 报告生成 | 自动 | 输出 stress_test_report_*.txt + stress_test_data_*.json |
— — —
五、结果解读与排错#
拿到报告先别急着按 FAIL 数淘汰线缆。顺序是:先确认配置真的生效 → 再读报告 → 最后才定位到具体问题。跳过第一步,很容易把"没测上"当成"测坏了"。
5.1 配置生效验证#
# 统计 400GE 端口 DOWN 数量,两台 Spine 均 ≥ 60 才算 PRBS 配置生效
display interface brief | include 400GE
未配置对端 checker 时端口显示 Current state: DOWN 属正常——两端都配上 PRBS 后才会 UP。
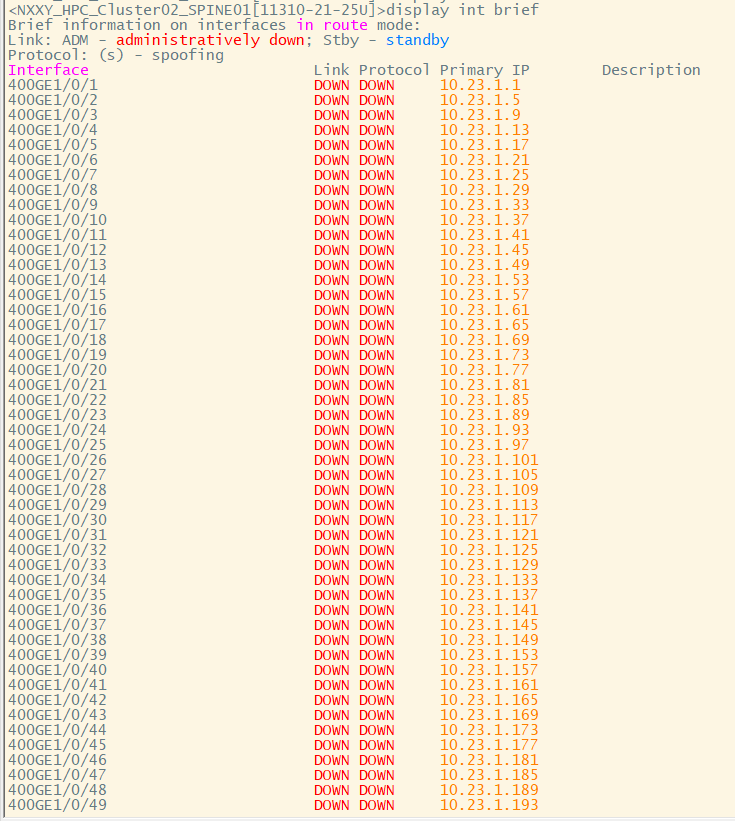
图:两台 Spine 的 64 个端口全部 DOWN,这是 PRBS 模式已生效的硬证据
✅ 报告里 FAIL 一片时,先回到这一步确认端口状态。如果端口没进 PRBS 模式,报告数字反映的是业务流量而不是物理层误码,整批数据作废。
5.2 报告结构#
stress_test_report_YYYYMMDD_HHMMSS.txt
├── 报告头(时间、方向、参数、统计摘要)
├── 详细结果表格(每条链路状态)
├── 时间序列波动分析
└── 判定标准说明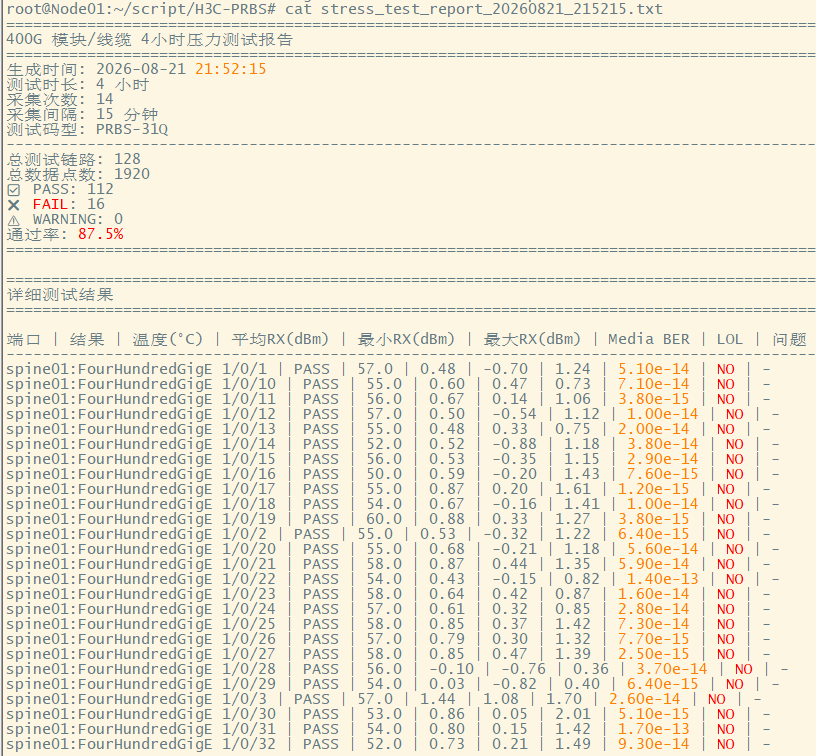
图:128 条链路、PASS 112、FAIL 16、通过率 87.5%,共 1920 个数据点
5.3 FAIL 端口不等于坏线:识别 N/A#
实测曾出现 16 个端口全部显示 N/A(无任何数据)导致整体 FAIL 的情况。N/A 通常是采集不到数据,而非物理故障,按概率排序:
| 可能原因 | 排查方式 |
|---|---|
| 光模块未插入 / 未上电 | 检查端口是否装齐模块 |
| 光纤端面脏污 / 接触不良 | 清洁端面后重插 |
| 端口未配置 PRBS | 确认配置阶段是否成功下发 |
| SSH 并发超时 / 解析失败 | 降低 MAX_WORKERS 后重试 |
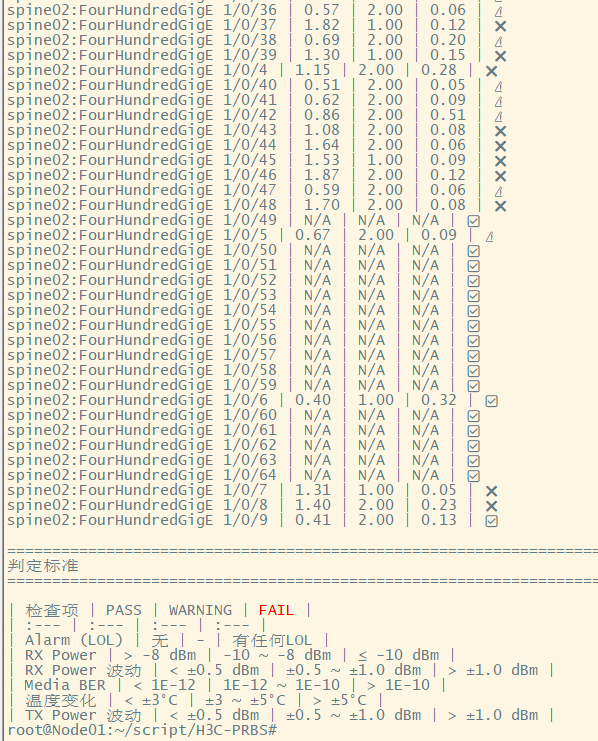
图:spine02 的 16 个端口温度 / RX 光功率 / Bias 全部显示 N/A,多为未接光模块或线缆
处理建议:压测前先用 display transceiver diagnosis interface X/X/X 逐个确认端口能读到数据,把读不到数据的端口提前排除在 PORT_MAPPING 之外。
5.4 按现象查表#
排除了采集问题、确认配置也生效之后,剩下的 FAIL 才是真故障。常见现象与处理:
| 现象 | 可能原因 | 处理 |
|---|---|---|
| 大量端口 FAIL | MPO 端面脏污 | cletop 清洁所有端面后重测 |
| 配置 PRBS 报错 | 模块不支持 CMIS 4.0 | 检查模块兼容性 |
| SSH 连接超时 | 网络抖动 / 并发过高 | 调小 MAX_WORKERS |
| 脚本中途退出 | SSH 断开 | 用 screen / tmux 运行 |
display transceiver diagnosis 无信息 | 接口 DOWN | 先 display interface 确认状态 |
| 测试结果异常 | 线缆未插紧 | 拔出重插至听到"咔哒"声 |
| VDM 首次读到 Max BER = 1.00E00 | 计数器刚清零的饱和值 | 属正常,运行后恢复真实读数 |
— — —
六、安全与规范#
测试会完全中断业务
必须在维护窗口或独立测试环境执行。
密码不得留占位符
config.py中所有your_password必须替换为实际值。必须挂 screen / tmux
单批 64 端口一轮采集涉及数百条 SSH 命令,断连即前功尽弃;双向合计 8 小时更要挂会话。
MPO 端面必须清洁
脏污会造成大面积 FAIL,污染测试结论。
按 PASS / FAIL 分区存放
测试完成的线缆分区放置,避免混用。
正反两份报告都要存档
上架前复核与后续复盘时对照查看。
MAX_WORKERS保持默认 16H3C SSH server 在高并发下会拒绝连接。
改完
config.py必须清缓存rm -rf __pycache__后再运行。
— — —
参考#
- H3C S9825-64D 产品手册(Comware V9):端口诊断与 PRBS 配置章节
- IEEE 802.3bs:400G 以太网 PAM4 调制与 FEC 规范
- OIF-CEI-4.0:通用电气接口实现协议(28G/56G 通道误码要求)
声明:本文所述测试方法与判定标准,仅供技术研究与测试参考。实际操作请结合自身设备型号、厂商手册与生产环境要求,并务必在维护窗口或独立测试环境中执行。