📌 转载说明:本文首发于微信公众号《闫工的算力工具箱》 原文链接:https://mp.weixin.qq.com/s/K8hlqBrngxF2WW842ZDfjA
【闫工的工具箱 · 第 17 弹|提效干货】#
大家好,我是闫工,前一段时间发布了“运维嘴替”的贴图文章把日志丢给小模型,搞了个“运维嘴替”。有好多朋友私信我,这个具体怎么做?有没有教程,这不就来了嘛。
先说个扎心的事实:夜班最大的敌人不是故障,是告警轰炸。
凌晨被手机震醒,群里几百条告警刷屏:OOM、超时、丢包、温控……真正需要爬起来处理的,往往只有一两条。告警越多,值班的人越麻木,等真出事的那条来了,反而没人理了。
我算过一笔账:被 300 条告警刷屏的那个夜里,手工翻日志找重点,平均 2 小时;后来我搞了个"运维嘴替",让 AI 替我把日志先看一遍,每天吐一张"一句话日报"。找重点从 2 小时压到 30 秒。
这篇把完整路线讲清楚,就三步:
- 第一步,把环境一次装好:Ollama + 一个主模型,两条路共用。这一步我 2 天翻车 4 次,3 个坑全实录,你先看能省一两天;
- 第二步,挑一条路走:轻量版一条 Prompt 就能吐日报,半小时跑通,适合先验证思路;RAG 版把历史日志切块、向量化,让它"认识"你的机房,适合长期用;
- 两条路共用同一套环境和模型,从轻量版升 RAG 版不用推倒重来。
不是 AI 替你做,是 AI 替你先看一遍。走起。
— — —
1. 痛点:为什么告警越多,人越麻木?#
夜班排障的真实节奏是这样的:
- 凌晨 2:47,手机震动,群里 300 条告警刷屏;
- 你眯着眼翻:OOM 一条、超时 50 条、丢包 30 条、温控告警 10 条、误报 200 条;
- 翻到第 20 条,你已经麻了——“反正都是老样子”;
- 真正致命的那条故障,混在 300 条里,被你划过去了。
告警系统的悖论:它想让你第一时间看到异常,但异常太多时,你就看不见异常了。
传统解法是"告警降噪":配规则、设阈值、做聚合。但规则是人写的,总有无数的边缘 case 漏过去;而且告警文本千奇百怪,光靠正则根本兜不住。
2. 破局:让 AI “先看一遍”,而不是"替你干活"#
我的思路很简单:不追求 AI 替你去修,只让它替你把日志看完、总结成人话。
技术上完全零门槛:
本地开源轻量模型(DeepSeek / Qwen 都行)
        +
一条 Prompt(只回答三件事:发生了什么、要不要管、怎么处理)
        +
[进阶] RAG(把历史日志向量化,让模型"认识"你的日志长什么样)为什么坚持用本地模型?
- 日志是敏感数据,不能随手丢给云端 API。金融、政务、医院客户对此是硬性要求。所以整套东西从装到跑都在你自己机器上:模型在本地、推理在本地,日志一步都不出机房;
- 轻量模型(7B 级别)在普通服务器上就能跑,不占 GPU 资源;
- 输出只要"一句话结论",不需要多聪明,够用就行。
— — —
3. 公共地基:先把环境一次装好(两条路共用)#
先打个预防针:不管你是走轻量版还是 RAG 版,前面的操作步骤一模一样。都要装 Ollama、拉同一个主模型。所以这段我按最全的标准写(RAG 版需要的,轻量版全用得上),你哪怕只想先跑通轻量版,照着做也一步不浪费。
实不相瞒,装这一步,我 1 天里翻车了 4 次。烂摊子全写出来,坑 1~3 就在这段,你看完也许能少走一两天。
3.1 装一个推理框架:Ollama#
Ollama 一条命令搞定模型下载和运行(Linux / macOS / Windows 都支持):
curl -fsSL https://ollama.com/install.sh | sh坑 1:脚本下到一半,SSL 断了。
官方脚本要现场下载一个 1.4 GB 的二进制包,网络一抽风就断:
curl: (56) OpenSSL SSL_read: error:0A000126:SSL routines::unexpected eof while reading, errno 0先看它抽风的样子:重试命令刚把进度推到 0.1%,SSL 握手就断了:
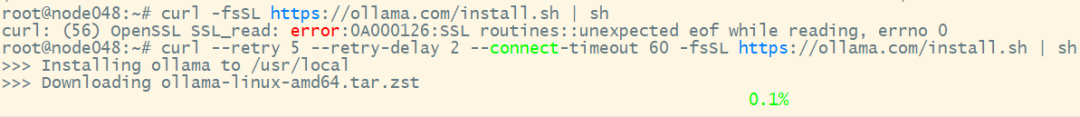
图:curl 命令 SSL 握手突然断流,进度条停在 0.1% 就断了
不死心,加 --retry 再试一次,进入第二坑:
>>> Downloading ollama-linux-amd64.tar.zst  # 1.9%
curl: (92) HTTP/2 stream 0 was not closed cleanly: PROTOCOL_ERROR (err 1)
... tar: Unexpected EOF in archive
HTTP/2 长连接被代理墙切断,1.4 GB 的二进制包下载到 1.9% 就崩了。
更换 DNS 或使用国内镜像源再试也行,我这里最终解法:官网下载到本地,scp 上服务器解决。
scp ollama-linux-amd64.tar.zst root@node048:~
ssh root@node048
sudo apt install -y zstd                # 没装就装一下
sudo tar --zstd -xf ollama-linux-amd64.tar.zst -C /usr/local
ollama --version
# Warning: client version is 0.33.2
~/ 目录里这个红框内容就是 scp 救场下来的 1.4 GB 包:
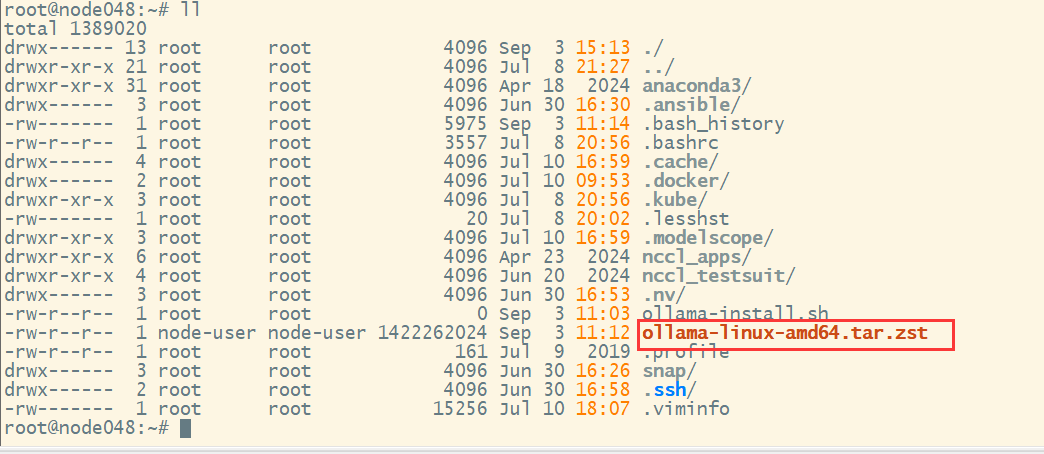
图:~/ 目录里这个红框就是 scp 救场下来的 1.4 GB 包
然后解压验证版本:
#解压到 /usr/local 目录(这是 Ollama 默认安装位置)
sudo tar --zstd -xf ollama-linux-amd64.tar.zst -C /usr/local
#验证安装
ollama --version
结果报错 Warning: could not connect to a running Ollama instance 忘了**服务还没开,**继续。
3.2 让服务真正活过来(别被 “enabled” 骗了)#
坑 2:systemd 看似 enabled,状态却是 FAILURE。
按网上教程配好 service 文件,daemon-reload + enable 一套连招:
sudo systemctl daemon-reload
sudo systemctl start ollama
sudo systemctl enable ollama
sudo systemctl status ollama
输出一片绿里一点红:
● ollama.service - Ollama Service
     Active: activating (auto-restart) (Result: exit-code) since ...
     Main PID: 237566 (code=exited, status=1/FAILURE)
别被 “enabled” 骗了——enabled 只代表"开机自启",不代表"现在活着"。active 那一行才是当前状态。status=1/FAILURE 八成是 service 文件里 ExecStart 路径写错,或者 /usr/local/bin/ollama 没执行权限。先 journalctl -u ollama -n 30 --no-pager 看几行日志,比猜快。
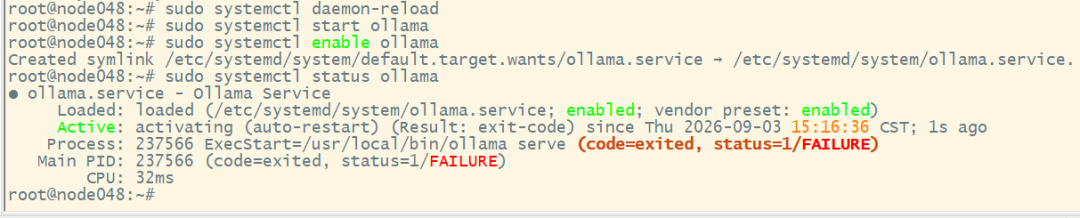
图:systemctl status 输出——enabled 是绿的,但 Active: activating (auto-restart) + status=1/FAILURE 才是真实状态
(这一步在生产前必须修好,否则后面拉模型、调用 API 全失败。)
3.3 拉主模型:deepseek-r1:7b#
服务活了,拉模型。7B 级别,普通机器跑得动,不占 GPU:
ollama pull deepseek-r1:7b
# 或者 Qwen 系列
ollama pull qwen2.5:7b
拉到 100% 的样子:
# pulling manifest
# pulling 96c415656d37: 100% ▕██████████████████▏ 4.7 GB/4.7 GB  50 MB/s
# verifying sha256 digest
# writing manifest
# success
图:ollama pull deepseek-r1:7b 拉满 100%,4.7 GB 全部写到磁盘
坑 3:拉满 100% ≠ 写入成功。
满速时 50 MB/s,看着很爽。但提前 df -h 看一眼:第一次拉一定先看 /root/.ollama(默认模型目录)所在盘 ≥ 10 GB 空余,否则会"看似下载完但写入失败",进度条骗你。
— — —
到这里,两条路的公共地基就打完了:Ollama 跑起来了、deepseek 主模型躺在盘上了。接下来分开讲:轻量版和RAG 版,同一个模型,不用拉第二遍。
3.4 岔路口:你要"现看现答",还是"带着历史上下文来答"?#
一个模型,两种用法。先看清区别再走,别走冤枉路:
| 维度 | 路线 A · 轻量版 | 路线 B · RAG 版 |
|---|---|---|
| 本质 | 现看现答:日志临时喂给模型 | 带着历史来答:先检索再回答 |
| 接下来要装 | 啥都不用,Prompt 写完就能跑 | 再拉 2 个 embedding 模型 + Python 包 + 建向量库 |
| 耗时 | 30 分钟(模型已就位) | 再花半天 |
| 懂你的程度 | 你喂多少它懂多少 | 越问越懂(历史日志都在库里) |
| 短板 | 记不住你机房的"正常"、长日志喂不全、黑话每次重新教 | 三条短板基本补齐,代价是要装要建库 |
| 适合谁 | 先验证思路 / 临时分析 | 长期用 / 日志敏感单位 / 要"记住"机房 |
我的建议:先走路线 A 跑两周,确认"AI 看日志"这事儿对你有用,再回来走路线 B。A 里装的环境、写的 Prompt,B 一个都不浪费。你要是时间紧、又确定要长期用,直接走 B 也行,A 的 Prompt 思路在 B 里原样复用。
轻量版,继续看第 4 章;RAG版直接跳到第 5 章。
— — —
4. 路线 A · 轻量版:一条 Prompt 的"日志嘴替"(零额外依赖)#
从岔路口往左走。模型已经在 3.3 拉好了,接下来只教它一件事:怎么汇报。
4.1 写 Prompt(直接抄)#
在终端敲下面这行,回车,就进了 Ollama 的对话界面(提示符变成 >>>):
ollama run deepseek-r1:7b
# 换成你 3.3 拉的那个模型名
然后,把下面这段 Prompt 整个复制,粘到 >>> 后面、回车。
你是一个资深运维工程师,正在替值班人员快速浏览日志。

请根据以下日志内容,回答三件事:
1. 发生了什么?(一句话说清楚)
2. 要不要管?(紧急/重要/可忽略)
3. 该怎么处理?(给出一条可执行命令或检查步骤)

要求:
- 每条事件只给一句话结论,不要展开分析
- 多起事件按紧急程度排序,最紧急的放最前面
- 如果全是正常日志,直接回答"一切正常"
- 不要编造日志里没有的信息
Prompt 写得再好,还有一个"胜负手"没打:你们日志里的"黑话"。像 [OOM]、[TIMEOUT]、[FW_DROP]……这些缩写 AI 一个都不认识,术语不懂,总结必跑偏。
⚠️ 让 AI 读懂你的"黑话"
这一步最关键:把机房的"黑话"先翻译给它。做法不复杂,在 Prompt 开头加一段【背景】,一条一行:
【背景】我们的日志中,[OOM] 表示内存溢出,[TIMEOUT] 表示连接超时,[FW_DROP] 表示防火墙丢包。教与不教,同样一份日志总结出来是两回事。
4.2 手动跑一次:把日志喂给它#
刚才在对话窗口里粘 Prompt、丢日志,是人肉一问一答:适合边聊边看效果,但每次都要手动操作,更没法定时。下面换成一条命令跑完的喂法——把 Prompt 和日志一次性打包丢给模型,它答完自己退出。这是给自动化铺路的一步,先手动跑顺,别急着上定时任务。
第一步:把 Prompt 存成一个文件。 4.1 那段 Prompt(连【背景】一起)存成 prompt.txt,后面定时任务直接读它,不用每次重打:
nano prompt.txt # 把 Prompt 粘进去 → Ctrl+O 存盘 → Ctrl+X 退出第二步:拿日志试一次。 注意别整份日志直接灌。模型一次能读的内容有限(上下文窗口),日志太长会被拦腰截断,前面的行没读完、最新的也没看到。先取最近 200 行试试水:
tail -200 /var/log/syslog.1 | ollama run qwen2.5:7b "$(cat prompt.txt)"这条命令拆开看,就三步:
tail -200 /var/log/syslog.1—— 取昨天轮转的日志,只要最后 200 行;
"$(cat prompt.txt)"—— 把 Prompt 全文塞进引号,当作给模型的"要求";
ollama run—— 把"要求 + 日志内容"一起发给模型,等它吐结论。
第一次跑要等模型预热,十几秒后屏幕上会出一段这样的总结(示意,你们日志不同、输出自然不同):
1. [紧急] sshd 登录失败次数激增,来源 10.0.0.8
   处理:fail2ban status sshd 看是不是爆破
2. [可忽略] md0 RAID 状态正常,例行事件
3. [可忽略] sched_clock 稳定,无需处理
看着还行,就把 200 换成 2000 行再试,看它会不会被大量例行日志"带偏"。这一步值得多试几天:每天花两分钟,拿它说的跟日志里的真相比一比,确认它"认得"你们日志的逻辑了,再进第 6 章把定时跑开起来。
⚠️ 核心原则:AI 的结论是**“参考"和"提醒”,不是"指令"**。它替你把日志看完、把线索递到你手上,接下来动不动手、怎么动手,得你自己拍板。任何修改操作,尤其是涉及生产环境的变更,都必须人工确认过再敲——它给的命令不核对就执行,出事的还是你。
4.3 效果:从 2 小时到 30 秒#
验证通过之后,值夜班节奏变成:
- 早上睁眼,扫一眼 AI 日报(怎么自动生成,第 6 章讲);
- “昨夜 3 起事件,1 起要管,怎么处理都写好了”;
- 该处理的处理,该忽略的继续睡。
找重点的时间,从原来的 2 小时(手工翻日志)压到 30 秒(看日报)。它不会替我去修故障,但把"从 300 条告警里捞真问题"这件最耗精力的事,替我做了。
但跑了一阵你会发现它有三道够不着的坎:记不住你机房的"正常"告警长什么样、日志一长就喂不全、换个场景黑话又得重新教。这就是 3.4 岔路口表格里说的短板。想补上?继续走路线 B。
— — —
5. 路线 B · RAG 版:让它"认识"你的日志#
基础环境已经在第 3 章就位,主模型拉好了、服务也活了,现在只差三件事:再拉 2 个 embedding 模型、装 Python 依赖、把历史日志建成知识库。
先看硬件门槛,手边一台服务器就够:
| 组件 | 最低 | 推荐 | 我这台 |
|---|---|---|---|
| CPU | 8 核 x86_64 | 16 核 | 24 核 |
| 内存 | 16 GB | 32 GB | 64 GB |
| 硬盘 | 100 GB(装模型) | 250 GB SSD | 1 TB SSD |
| GPU | 不要 | 可选(推理加速) | 纯 CPU,照样跑 |
| 网络 | 仅拉模型时联网一次 | — | 装完局域网通就行 |
注意:主模型 3.3 已经拉好了;现在把两个 embedding 模型(约 700 MB)拉下来。
5.1 多拉两个 embedding 模型(坑 4)#
RAG 要把日志切成向量。DeepSeek 这种"会聊天"的大模型不擅长。要再拉两个专门做"句子转向量"的小模型:
ollama pull shibing624/text2vec-base-chinese   # 中文日志主力
ollama pull nomic-embed-text                    # 英文补充
ollama list
NAME ID SIZE MODIFIED
nomic-embed-text:latest 0a109f422b47 274 MB 5 seconds ago
shaw/dmeta-embedding-zh:latest 41783961c26d 408 MB 29 seconds ago
deepseek-r1:7b 755ced02ce7b 4.7 GB 33 minutes ago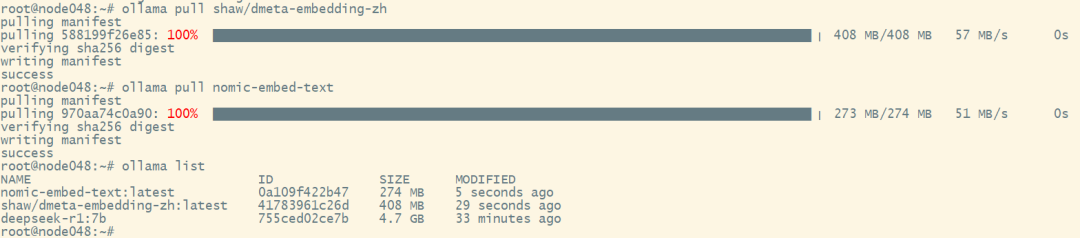
图:两个 embedding 模型(dmeta-embedding-zh 408MB + nomic-embed-text 274MB)拉完之后,ollama list 看到三个模型就绪
三个模型加一起 5.4 GB。
5.2 装 Python 依赖:两个"抄代码必踩"的坑#
模型齐了,接下来写 RAG 的 Python 代码。这段代码网上几乎都能抄到,但真的抄过来跑不动。两个坑提前给你排掉。
坑 5:LangChain 1.3 把模块拆走了。
ModuleNotFoundError: No module named 'langchain.text_splitter'
ModuleNotFoundError: No module named 'langchain.chains'
LangChain 1.3 把模块改组了,原本在 langchain.text_splitter、langchain.chains 下的东西,拆到独立包:
pip install langchain langchain-core langchain-community \
            langchain-text-splitters langchain-classic
pip install chromadb sentence-transformers
新版 import 写法:
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_classic.chains import RetrievalQA     # 注意路径变了
from langchain_community.document_loaders import TextLoader
from langchain_community.vectorstores import Chroma
from langchain_community.embeddings import OllamaEmbeddings
from langchain_community.llms import Ollama
不要直接看 1.0 之前的教程抄代码。抄完必报错。
坑 6:AI 写的代码,缩进歪了不稀奇。
第二个脚本我让 DeepSeek 重写一遍,结果 if query.lower() ... 用vim编辑器缩进格式有问题:
File "/root/query_log.py", line 31
    if query.lower() in ['exit', 'quit']:
IndentationError: unexpected indent
Python 最经典的报错:第 31 行有缩进、第 30 行没缩进,while True: 下面那层逻辑必须整体往里挪 4 个空格。vim/VS Code 里按 == 自动格式化一遍即可。或者换其他编辑器,比如 nano 。
5.3 建知识库(首次 5–10 分钟)#
坑都填平了,下面两步就是日常操作。先新建 build_rag.py:
from langchain_community.document_loaders import TextLoader
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_community.vectorstores import Chroma
from langchain_community.embeddings import OllamaEmbeddings
import os
LOG_FILE = "/var/log/syslog"   # 改成你自己的日志
DB_DIR = "./log_db"
embeddings = OllamaEmbeddings(
    model="shaw/dmeta-embedding-zh:latest",   # 中文嵌入
    base_url="http://localhost:11434",
)
print(f"开始构建日志知识库...")
loader = TextLoader(LOG_FILE, encoding="utf-8")
docs = loader.load()
splitter = RecursiveCharacterTextSplitter(chunk_size=500, chunk_overlap=50)
chunks = splitter.split_documents(docs)
print(f"已切分为 {len(chunks)} 个文本片段")
print("正在生成向量并存储(首次运行可能稍慢)...")
db = Chroma.from_documents(chunks, embedding=embeddings, persist_directory=DB_DIR)
db.persist()
print(f"✅ 知识库已保存到: {DB_DIR}")
跑一遍:
✓ 成功加载日志文件:/var/log/syslog(共 1 个文档)
✓ 已切分为 611 个文本片段
✓ 正在生成向量并存储...
✅ 知识库已保存到: ./log_db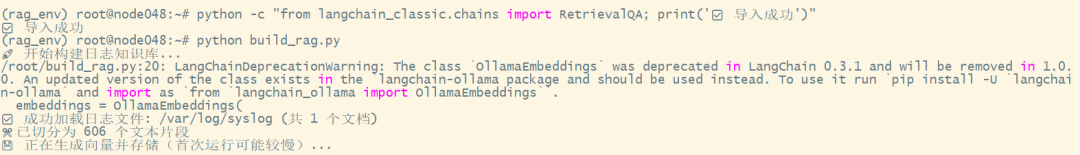
图:build_rag.py 跑完,成功输出 611 个文本片段并存进 ./log_db
611 个文本片段。这就是把 1 MB 的 syslog 切成 500 字符一段、保留 50 字符重叠后的结果。
5.4 提问(在线会话,秒级响应)#
再新建 query_log.py:
from langchain_community.vectorstores import Chroma
from langchain_community.embeddings import OllamaEmbeddings
from langchain_community.llms import Ollama
from langchain_classic.chains import RetrievalQA
embeddings = OllamaEmbeddings(
    model="shaw/dmeta-embedding-zh:latest",
    base_url="http://localhost:11434",
)
db = Chroma(persist_directory="./log_db", embedding_function=embeddings)
retriever = db.as_retriever(search_kwargs={"k": 5})
llm = Ollama(model="deepseek-r1:7b", base_url="http://localhost:11434", temperature=0.2)
# 把你公司日志的"黑话"喂给它
PREFIX = """【背景】我们的日志中,
[OOM] 表示内存溢出,
[TIMEOUT] 表示连接超时,
[FW_DROP] 表示防火墙丢包。
"""
qa = RetrievalQA.from_chain_type(llm=llm, retriever=retriever, return_source_documents=False)
print("🤖 RAG 日志分析已就绪(输入 'exit' 退出)")
while True:
    q = input("\n💬 请输入您的问题:")
    if q.strip().lower() in ("exit", "quit"):
        break
    full_q = PREFIX + q
    ans = qa.invoke({"query": full_q})
    print("\n⏳ 分析结果:")
    print(ans["result"])
启动——
✅ 成功加载知识库: ./log_db
🤖 RAG 日志分析已就绪(输入 'exit' 退出)
💬 请输入您的问题:
光标在闪。从这一刻起,进入"问一答一"模式。
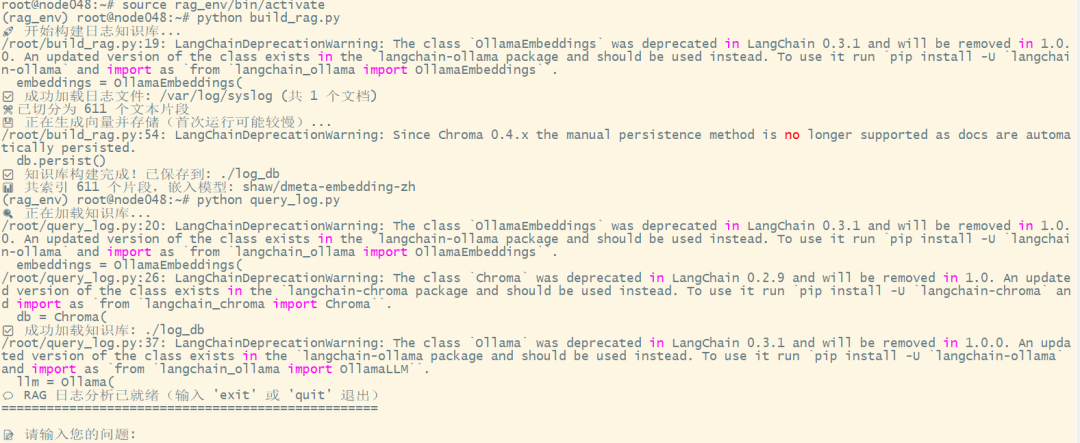
图:build_rag.py 跑完 + query_log.py 启动成功,输出"🤖 RAG 日志分析已就绪(输入 ’exit’ 退出)"+ “请输入您的问题:”
5.5 真用起来:3 个真实问题,看 AI 怎么答#
下面这几个问题,是我把脚本跑起来后真实敲进去的,结果原汁原味贴出来,不修饰。
测试 1:直接问"今天有没有错误"
💬 今天有没有错误
⏳ 分析结果:
1. 今天发现了几起异常事件:
   - GPT:Alternate GPT header not at the end of the disk.
   - GPT:1562378239 != 1562824367
   - GPT: Use GNU Parted to correct GPT errors.
2. 这些异常可能表明硬盘分区信息存在问题,建议进行检查和修复。
3. 建议执行以下命令以检查和修复硬盘分区:
   sudo gparted -l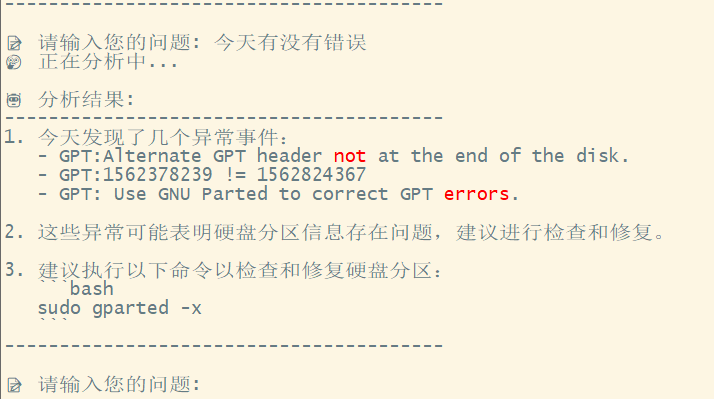
图:测试 1 输出
AI 自己看出了 GPT 分区表错位,还给出修复命令。这条日志要靠人眼翻,得翻半天;它直接给我结论。
测试 2:问个更宽的"日志里有什么问题"
💬 日志里有什么问题
⏳ 分析结果:
1. 事件:节点048的 usb 2-1 设备描述符读取失败。
2. 事件:节点048的 sched_clock 日志显示稳定。
3. 事件:节点048的 sd 7 和 sd 6 的 SCSI 设备已连接。
4. 事件:节点048的 md/raid1 状态正常。
5. 事件:节点048的 igb 接口被重命名。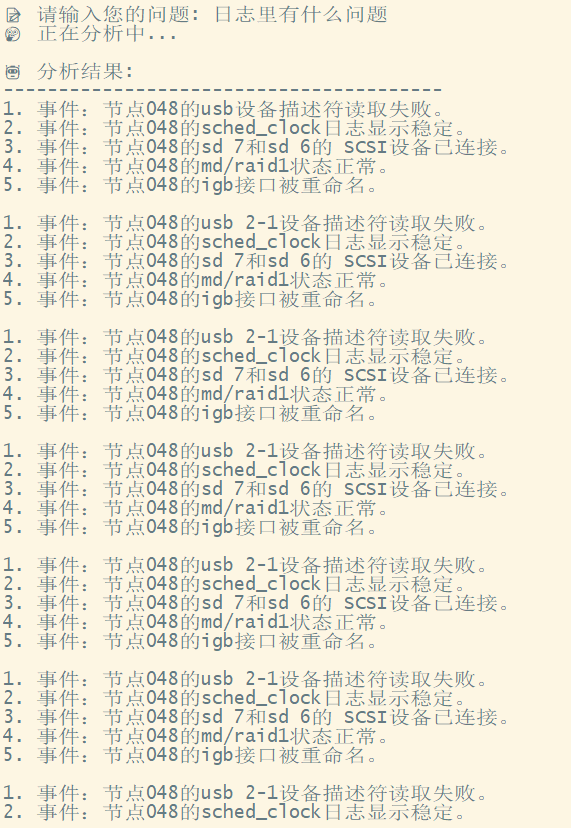
图:问"日志里有什么问题",AI 把节点048 当天 5 条事件都列了出来——其中 usb 设备描述符读取失败是真异常,其他几条要靠人工过滤
5 条事件按"事件:节点 + 动作"统一格式列出来,真有"运维日报"那种感觉。只是有几个"事件"其实是正常状态(sched_clock 稳定、md 正常),AI 没完全分清"异常"和"事件",需要再调。
要治这个毛病,不用改代码,在提问时给它加一道约束就行。比如把问题改成:“只列出可能影响业务或需要人工介入的异常事件,忽略系统例行状态日志。“问法换个说法,它筛出来的结果就干净一大截。
测试 3:把"黑话"喂给它,再问专业问题
这条最贴近日常用。轻量版 4.1 那条【背景】 Prompt,在这里原样复用:
💬 【背景】我们的日志中,[OOM] 表示内存溢出,[TIMEOUT] 表示连接超时,[FW_DROP] 表示防火墙丢包。今天有啥问题?
⏳ 分析结果:
1. 发生了什么?
   - 系统资源管理异常,包括内存和 I/O 操作异常。
   - 网络防火墙丢包,可能影响系统安全与性能。
   - 系统资源初始化过程存在异常,如堆内存分配和保留异常。
   - 系统安全机制运行正常,未发现异常。
2. 要不要管?
   - 资源异常:管。
   - 网络丢包:管。
   - 初始化异常:管。
3. 怎么处理?
   - OOM:减少进程占用、优化内存管理。
   - 防火墙:检查防火墙规则、保证流量正常、必要时调整。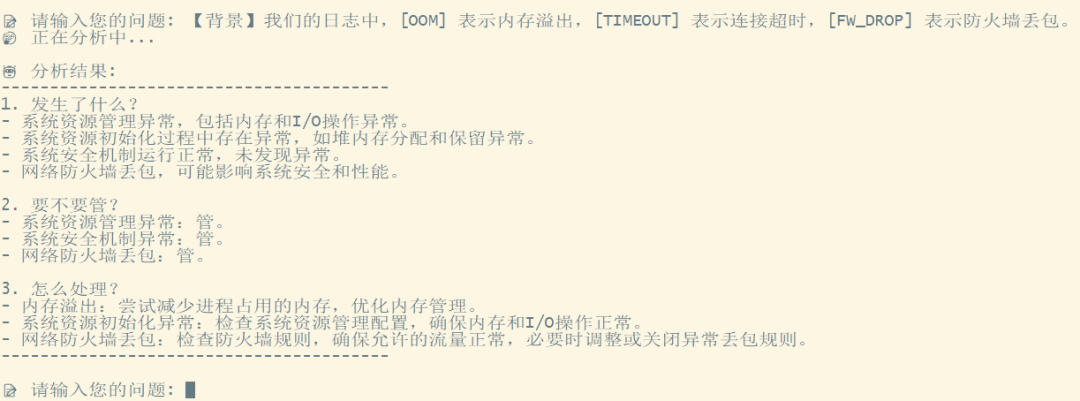
图:【背景】Prompt 在 RAG 模式下复用,把黑话[OOM]/[TIMEOUT]/[FW_DROP] 喂进去,输出标准三段式结论
出来的还是"发生了什么 / 要不要管 / 怎么处理"三段式结论。轻量版那套 Prompt 套路,RAG 版原样接得住,而且更准——它不是凭空猜,是翻着你机房真实的历史日志在答。
⚠️ 首次运行后,先人工抽查几个回答,再大规模使用:重点看 AI 对"黑话"的理解准不准:[OOM] 有没有认成内存溢出、例行事件有没有被当成故障。抽查几轮确认靠谱,再把它当日常工具;这一步省了,后面错判错报都得你买单。
— — —
6. 自动化:两条路都能每天吐日报#
手动跑顺了,就该让它自己跑了。轻量版和 RAG 版的 cron 是同一套思路:把昨天的日志丢给 AI,结论追加进一个日报文件,模型名换成你那条路用的就行。手动执行亲自比对日报质量,确认稳定了,再开启 cron 自动执行。总结错一条不可怕,可怕的是从此不再核对、把错的当成对的。
cron 可以这么写:
# 每天 08:00,把昨天的日志丢给 AI,结论写进日报
0 8 * * * cd /opt/log_ai && \
  /usr/local/bin/ollama run deepseek-r1:7b \
  "$(cat prompt.txt)$(cat /var/log/syslog.1)" \
  >> /var/log/ai_daily_report.md 2>&1
跑出来的日报长这样。每天 08:00 自动触发,AI 把一夜的日志总结成几句人话:
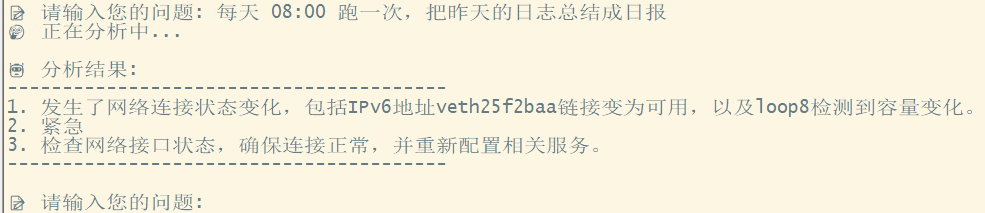
图:cron 实跑出来的日报样例——输出"网络连接状态变化(IPv6 veth25 / loop8 检测到容量变化)“这类人话总结
4 个小坑,提前说:
- prompt.txt 写在文件里,比
echo "$..."干净,cron 不擅长转义多行 Prompt; syslog.1 是昨天轮转过的日志,当天日志还在写,不能锁定读;- 输出
>>追加比>覆盖更稳,重跑不会丢历史日报; - 重定向
2>&1把 Ollama 报错也留住,方便排错。
定时开起来之后:早上睁眼扫一眼日报,2 小时的事变 30 秒。
— — —
END#
你的夜班是怎么熬的?凌晨被几百条告警刷屏过吗?评论区聊聊,一起想办法。你的日志里最难读懂的黑话是什么? 有些机房自造的缩写,新同事看一年都懵。评论区晒出来。攒够了,我找机会做一篇"机房黑话翻译”,专治这种懵。
“日志嘴替"把日志看完了,但我的"偷懒"还没完。3 个让我大幅减少重复劳动、每天早下班的 AI 工作流:日志一句话分析、Excel 资产盘点、一键巡检。
下期,聊聊我的懒人哲学:懒不是少干活,是把重复的活交给AI,时间还给自己。
往期回顾:
官网TFLOPS写312实测67:算力"虚标"的锅,可能不在你的GPU
ESXi系统盘重装后虚拟机消失?别慌,三步救回数据盘里的虚拟机