📌 转载说明:本文首发于微信公众号《闫工的算力工具箱》 原文链接:https://mp.weixin.qq.com/s/SNfrxWXajZTCAyi7Wj9q1A
【闫工的工具箱 · 第 27 弹|运维兵器库】#
我是闫工,数据中心搬砖的 CCIE。
节点上 GPU 掉了一张,nvidia-smi 里那张卡显示 Unknown Error。找售后开单,对面第一句话就是:“麻烦把 nvidia-bug-report 和 nvidia-smi -a 的输出发过来。”
听起来简单,实际是:SSH 上去敲 nvidia-bug-report.sh,等它跑完还得 find 一遍找文件;再 nvidia-smi -a 重定向、lspci 过滤、dmesg 抓报错、内核模块列表存一份……一台机器十几条命令,敲完还得 scp 拖回来、按机器名建目录。加上生产环境 SSH 端口改过、有几台必须走跳板机,光收日志就半个多小时,这活一点没得省。
第一次我漏了 dmesg,售后回邮件让我补;第二次漏了 PCIe 的 AER 统计,又来一轮。漏一次补一次,来回两三天过去了,机器还在那儿挂着。
后来我把这套活写成了脚本,现在收日志就是一条命令的事。
— — —
手工收日志,烦在三件事上#
一是清单靠记。 售后要的东西不止一个文件:官方诊断报告、nvidia-smi -a 全量状态、PCI 设备详情、内核日志、内核模块、系统版本、PCIe 错误统计……漏哪一项都要来回一轮。而且这些项目不是背下来就行,不同故障要看的侧重点还不一样(掉卡看 PCIe 和内核日志,性能异常看 nvidia-smi -a 和 ECC 计数)。
二是环境不一致。 生产环境该加固的都加固过:SSH 端口不是 22 了,管理网不能直连得走跳板机。手工敲的时候,ssh -p、scp -P、-J 跳板机这几样混在一起,很容易写错一个参数然后连不上,再花十分钟排查是端口问题还是密钥问题。
三是归档乱。 拖回来的文件丢在一个目录里,过两周再看,nvidia_smi_a.txt 到底是哪台机器的?只能靠时间戳猜。要是同时收好几台,基本就分不清了,净是麻烦事。
— — —
脚本干的事:一条命令,9 类日志#
设计思路很简单:一条命令,把售后可能要看的东西一次收齐,按机器 SN 建目录归档。
用法就这么几行:
# 默认 22 端口直连
./collect_gpu_logs.sh 192.168.1.100

# 目标服务器 SSH 端口不是 22
./collect_gpu_logs.sh -p 2222 192.168.1.100

# 要走跳板机
./collect_gpu_logs.sh -j "user@jump-host" 192.168.1.100

# 跳板机和目标都不是 22 端口
./collect_gpu_logs.sh -p 2222 -j "user@jump-host:2200" 192.168.1.100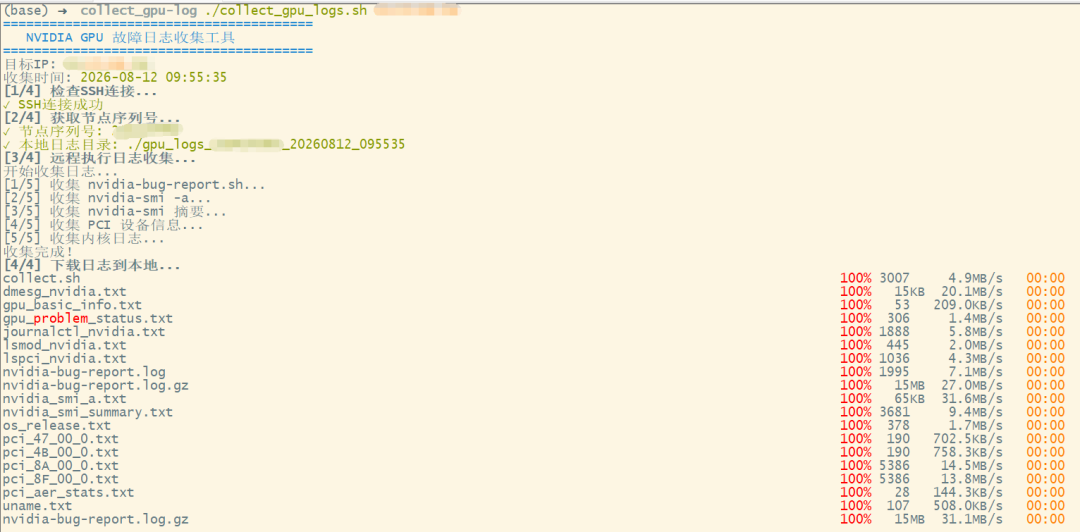
图:一条命令跑完四个阶段,日志自动落到本地目录(IP、跳板机、SN 已打码)
它到底收哪些东西,我把清单列出来——这张表你可以直接拿去对售后要的东西:
| 收集项 | 文件 | 干什么用 |
|---|---|---|
nvidia-bug-report.sh | nvidia-bug-report.log.gz | 官方完整诊断报告,RMA 必交 |
nvidia-smi -a | nvidia_smi_a.txt | GPU 全量状态:温度、功耗、ECC、PCIe |
nvidia-smi | nvidia_smi_summary.txt | 状态摘要,一眼看健康度 |
lspci -nn | lspci_nvidia.txt | NVIDIA PCI 设备清单 |
lspci -vvv -s <BDF> | pci_XX_XX_X.txt | 问题 GPU 的 PCI 详情,查识别问题 |
dmesg 加 grep 过滤 | dmesg_nvidia.txt | 内核日志里的 GPU 报错 |
journalctl -k | journalctl_nvidia.txt | 系统日志里的 GPU 相关 |
nvidia-smi --query-gpu | gpu_basic_info.txt | GPU 索引、型号、UUID、PCI 地址 |
| AER 统计 | pci_aer_stats.txt | PCIe 错误计数,定位链路问题 |
加上 uname -a、/etc/os-release、lsmod | grep nvidia 这几个系统信息,一共 9 类。
跑完自动打包成 ${SN}_${时间戳}_logs.tar.gz,一条命令丢给售后。收完的终端会直接告诉你"接下来该看哪几个文件":
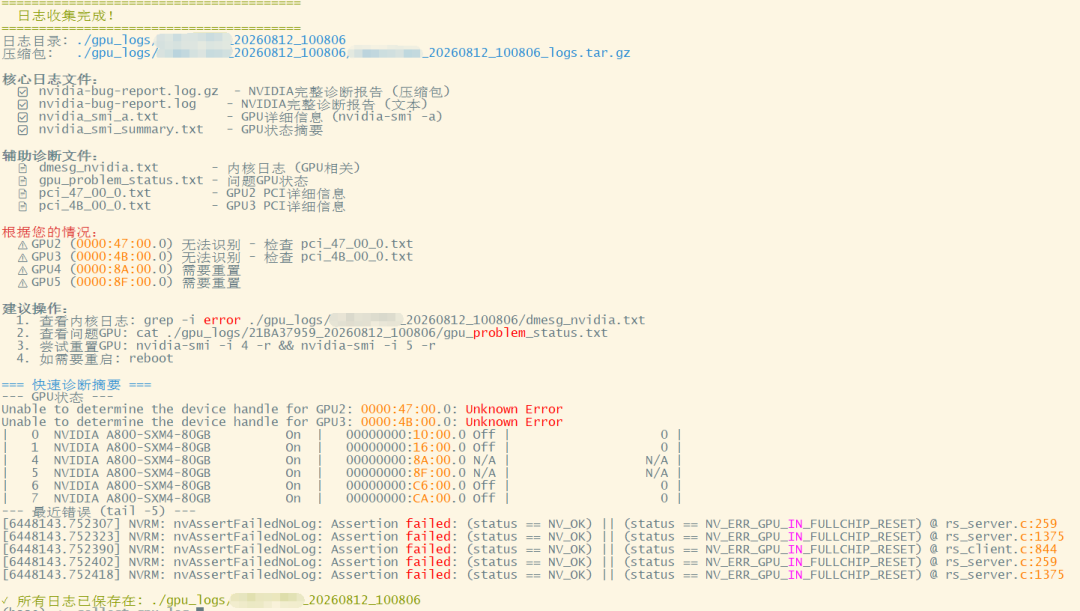
图:跑完的输出——核心日志已就位,并直接点出哪几张 GPU 报错、下一步该 grep 什么
— — —
三个容易翻车的细节,我是这么处理的#
目录按 SN 命名,不按 IP#
脚本先通过 dmidecode -s system-serial-number 把机器 SN 取出来,用它建目录:
./gpu_logs/
└── 21BA37959_20260812_095535/          # SN_时间戳
    ├── nvidia-bug-report.log.gz
    ├── nvidia_smi_a.txt
    ├── dmesg_nvidia.txt
    ├── pci_aer_stats.txt
    ├── ...
    └── 21BA37959_20260812_095535_logs.tar.gz
为什么不用 IP? 因为 IP 是会被回收再分配的,机器重装、换网段都会变,但 SN 跟着硬件走。三个月后翻日志,看 SN 能直接对到机柜里的那台物理设备;看 IP 就只能猜了。
取不到 SN 的时候(有些虚拟机或者 BMC 没填),脚本会退回用 IP 下划线化作为目录名,并在终端里明确提示一句"无法获取序列号,使用 IP"——不静默兜底,让人知道这份归档的标识不是 SN。
跳板机的两种连法,SSH 和 SCP 写法不一样#
这是最容易翻车的地方。SSH 用 -J,SCP 用 ProxyJump,而且要保证传输时走的还是同一条跳板路径:
# SSH:-J 跳板机
ssh -J user@jump:2200 -p 2222 root@target

# SCP:用 ProxyJump,端口一样要带
scp -o ProxyJump=user@jump:2200 -P 2222 root@target:/tmp/logs/* ./脚本里我是把两套命令分别构建的(build_ssh_cmd / build_scp_cmd),不共用参数拼接——因为它们的大小写和参数名本来就不一样,硬凑到一起必然出错。
端口参数分开传,不从 -j 里猜#
-p <端口>    目标服务器的 SSH 端口(默认 22)
-j <跳板机>  格式 user@host 或 user@host:port
跳板机端口写在 -j 里(user@jump:2200),目标端口用 -p 单独给。两个端口互不干扰,脚本内部自己从 -j 里把 host 和 port 拆开。
不加这两个参数的老用法完全兼容:./collect_gpu_logs.sh 192.168.1.100 照样能用。
— — —
我踩过的几个坑#
SSH 是小写 -p,SCP 是大写 -P。 这个坑我栽过不止一次:
ssh -p 2222 root@host          # 小写
scp -P 2222 root@host:/f ./    # 大写,容易顺手写成小写
写成小写,SCP 会把 2222 当成要传的文件名,然后报"文件不存在",你还得反应一下才知道是参数写错了。
-J 后面的端口指跳板机,不是目标机。 这个更容易混:
# 对:跳板机 2200,目标 2222
ssh -J user@jump:2200 -p 2222 root@target

# 错:2200 被当成了目标端口
ssh -J user@jump -p 2200 root@target
第二种写法在跳板机不是默认端口时能连上跳板机,但连不上目标,报的错又含糊,很容易怀疑是密钥问题。
nvidia-bug-report.sh 会跑很久。 它要遍历驱动状态、抓大量系统信息,机器负载高的时候几分钟都出不来。实测在高负载节点上跑一次要 3–5 分钟,业务低峰期也要 2 分钟左右。 脚本里我加了 120 秒超时,超时就跳过并记录下来;如果确实需要完整报告,就在业务低峰期单独在机器上跑一遍。
日志里的信息其实挺敏感。nvidia-bug-report 和 nvidia-smi -a 里含序列号、GPU UUID、主机名、内核参数。传输走 SSH 是加密的,但落地之后别随手往公网网盘或者公共群里丢——这台机器的身份信息都在里面。
— — —
顺手做的两个衍生用法#
收日志这件事一旦脚本化,往下就能长出别的用法。
批量收:机器列表丢一个文件里循环跑:
for ip in $(cat iplist.txt); do
    ./collect_gpu_logs.sh $ip
    sleep 2
done定期巡检:不故障的时候也每天收一遍摘要,攒成时间序列。真出问题时,你手上有"故障前三天是什么样"的对照数据,比只有故障当天的快照有用得多:
# 生成巡检报告:每台机器的型号、风扇、温度、功耗
echo "=== 巡检报告 $DATE ===" > $LOG_DIR/report.txt
for log in $(find ./gpu_logs -name "nvidia_smi_summary.txt"); do
    echo "--- $(basename $(dirname $log)) ---" >> $LOG_DIR/report.txt
    grep -E "Product Name|Fan Speed|Temperature|Power" $log >> $LOG_DIR/report.txt
done还有一件小事:归档要按月分。单个节点的日志 15–20MB,看着不多,几十台跑一个月就是几个 GB。我现在的做法是 mv ./gpu_logs/* ./archive/$(date +%Y%m)/,月底清一次。
— — —
日志收回来之后呢#
这里得说清楚:这个脚本只负责"把料备齐",不负责诊断。
日志到手之后是三条路:
- 要报 RMA 或者走售后,
nvidia-bug-report.log.gz是必交材料,配合硬件诊断工具跑一遍完整工作流(第 20 弹写过NVIDIA Field Diagnostic 完整工作流:GPU 报障与 RMA 前的硬件体检); - 看起来像硬件故障但只是怀疑,可以对照 NVLink 链路、掉卡这类案例排查(第 12 弹是 NVLink 坏一半GPU全在、驱动正常,训练就是卡死——NVLink悄悄坏了一半、第 13 弹是高温掉卡8卡变7卡、93°C还在Throttling:卡没坏,是热到"自我降速"了);
- 想快速定位,可以把日志喂给本地模型先过一遍,让它给出可疑点排序(第 17 弹写过这套本地 RAG被告警炸醒后,我把DeepSeek装进了机房:从一行命令到本地RAG的6个坑)。
所以链条是:收集(这篇)→ 诊断(第 20 弹)→ 分析(第 17 弹)。哪一环缺了,后面都得返工。料先备齐,后面才好。
— — —
为什么这套东西值得抄?#
清单固定
9 类日志一次收齐,不会因为"忘了某项"来回补两三天
环境自适应
跳板机、非默认端口都覆盖,生产环境什么姿势都能收
归档可追溯
SN + 时间戳命名,三个月后还能对回机柜里的物理设备
一条命令
不用记参数顺序,也不用在每个节点上重复敲十几行
能长出巡检
同一套脚本改改就是批量收集和每日体检,拿来就能用
— — —
结尾 · 互动#
你们那边 GPU 报障的时候,售后一般要哪些日志?有没有因为少交一项,来回补了两三天的经历?
关注【闫工的算力工具箱】,硬核实战经验,带你轻松避坑!