📌 转载说明:本文首发于微信公众号《闫工的算力工具箱》 原文链接:https://mp.weixin.qq.com/s/E9G6HOcS3PJClwyMCQM-4A
【闫工的工具箱 · 第 23 弹|网络验收】#
我是闫工,数据中心搬砖的 CCIE。
前阵子帮客户审核一份 GPU 集群的交付验收报告,翻到第二页我就被气笑了——
“测试状态"那一列,写的不是"通过”,也不是"不通过",居然填了一个数值:477.09。
再往下一看,更绝了:mpirun 命令错漏百出,IP 段从 192.168 凭空跳到 192.169,主机列表还用了冒号嵌套;而这一项填的实测值 773.79 GB/s,居然和上面另一个完全不同负载的测试项一模一样。
这份报告,只能说现场有人按过 Enter 键,绝不能说它验过了集群。
智算中心交付不是"跑通 NCCL 就算完事"。今天把这套从"只测 RoCE 网"扩充到 6 个网络平面的完整验收体系分享出来:包含标准平面、执行顺序、可直接运行的脚本骨架和整改闭环模板,建议收藏备用。
— — —
先说结论:为什么只测计算网不行#
智算集群不是只有一张 RoCE / IB 计算网。
只测计算网,等于只验了发动机,油路、电路、散热、车架全没看。客户的业务要跑起来,靠的是所有承担流量的网络平面一起工作:算得起来(计算网)、管得着(带外)、存得进(存储网)、出得去(出口)。
任何一个平面漏测,交付当天看不出来,上业务之后才炸。验收时发现是返工,上业务后发现是事故。
⚠️ 所有验收阈值都必须按合同或招标书改。阈值不改,测出来的结论没有意义。 后面脚本里的数值全是示例。
— — —
我列的 6 个网络平面#
| 平面 | 承载什么 | 关键指标 | 用什么工具 |
|---|---|---|---|
| ① RoCE/IB 计算网 | GPU 间集合通信(NCCL) | 读写带宽、延迟、GPUDirect、PFC | ib_write_bw / ib_read_bw / ib_send_lat / nccl-tests |
| ② 业务管理网 | 节点间 SSH、NFS、调度 | 连通性、TCP 带宽、挂载、DNS | ping / iperf3 / dd |
| ③ 带外管理网(BMC) | 远程开机复位、读传感器 | BMC 可达、传感器、SEL 日志 | ipmitool |
| ④ IB 存储网(客户端) | 计算节点 ↔ 存储前端 | IB 带宽、挂载 IO、并行 IO | ib_write_bw / ior |
| ⑤ 外部互联网出口 | 公网、软件源、下载、安全策略 | 公网 HTTP、DNS、下载速率、22 端口应阻断 | curl / dig / nc |
| ⑥ 存储内部网(后端) | 存储节点间副本同步、心跳 | 节点间 IB 带宽、路由隔离 | ib_write_bw / ceph |
不是所有集群都要全测,这两个可以标 N/A:
- ⑤ 外部出口:纯内网集群不用测;
- ⑥ 存储后端:只有分布式存储(Ceph / Lustre / GPFS)必测,本地盘或单一 NFS 可以跳过。
— — —
执行顺序:先保命,再保性能#
BMC 带外 → 业务管理网 → 存储内部 → 存储客户端 → RoCE 计算 → 外部出口这个顺序不是随手排的。
先确认带外可达,后面任何节点 hang 死都能远程复位。 带外没通就开始测性能,万一机器卡住了,只能推车进机房手动重启——现场节奏一崩,后面全乱。
然后由下往上叠:管理网通了才能远程操作节点,存储通了才能跑 IO,最后才是计算网的性能。
📌 闫工贴士:验收现场第一条铁律 —— 带外(BMC)没通,绝不开始测计算网性能。性能测试会把机器压到满载,一旦 hang 死,没有带外就只能进机房按电源键。几十台机器跑下来,节奏一崩,后面所有测量都不可信。
— — —
验收报告怎么写#
报告结构固定下来,现场就不会漏项:
GPU 高性能计算集群——全网络平面集成验收报告
├─ 总体结论与问题摘要
├─ 第一部分  RoCE/IB 计算网络验收
├─ 第二部分  业务管理网络验收
├─ 第三部分  带外管理网络(BMC/IPMI)验收
├─ 第四部分  IB 存储网络(客户端)验收
├─ 第五部分  外部互联网出口网络验收
├─ 第六部分  存储内部网络(后端)验收
├─ 第七部分  未达标项跟踪表
├─ 第八部分  附件清单(脚本 CSV 输出)
└─ 第九部分  签字确认
每个平面章节里用同一张测试项表格,把脚本输出的 CSV 回填进去:
| 序号 | 模块 | 测试项 | 测试命令 | 验收标准 | 结论 |
|---|---|---|---|---|---|
| 1.1 | RoCE | 写带宽 | ib_write_bw -d mlx5_x | ≥ 740 Gb/s | □通过 □不通过 |
| 2.1 | 业务 | 连通性 | ping -c 100 <IP> | 丢包 = 0% | □通过 □不通过 |
| 3.1 | BMC | IP 可达 | ping <BMC_IP> | 100% 可达 | □通过 □不通过 |
| 5.1 | 出口 | 公网连通 | curl https://www.baidu.com | HTTP 200 | □通过 □不通过 |
结论分三档,别只写"通过/不通过":
| 结论 | 判定标准 |
|---|---|
| 通过 | 全部测试项达标,无遗留问题 |
| 有条件通过 | 关键项全部达标,非关键项待补,且已约定整改时限与责任人 |
| 不通过 | 任一关键平面有未达标项(带宽 / 延迟 / 连通性硬指标没过) |
铁律一条:任何单项标"不通过",总结论就不能写"通过",必须进未达标项跟踪表闭环整改。
— — —
6 个脚本,输出统一格式#
6 个脚本的输出格式是一致的:文件名带时间戳,表头固定为 测试时间,测试项,验收标准,实测值,单位,结论。这样汇总的时候直接往 Excel 里贴就行。
⚠️ 所有阈值(
TH_*)都是示例值,必须按合同或招标书改。以计算网带宽为例:本文的 740 Gb/s 是按单端口 800G 或 2×400G 网卡给的。集群如果用的是 200G / 400G 网卡,这个阈值要按比例下调,否则整列都是"不通过"——那不是机器不行,是阈值抄错了。
脚本 ①:计算网#
覆盖链路状态、读写带宽、往返延迟、GPUDirect,以及可选的 NCCL all_reduce。骨架是这样:
#!/bin/bash
# 用法: ./roce_compute_network_test.sh <peer_ip> <ib_device> [nccl_node_file]
set -u
PEER=${1:?用法: $0 <peer_ip> <ib_device> [nccl_node_file]}
DEV=${2:?缺少 IB 设备, 如 mlx5_0}
TS=$(date +%Y%m%d_%H%M%S); OUT="roce_test_results_${TS}.csv"
TH_BW=740      # Gb/s 验收下限(示例;按单端口 800G 或 2x400G 网卡设定,200G/400G 网卡需下调)
TH_LAT=3.0     # us 验收上限(示例)
echo "测试时间,测试项,验收标准,实测值,单位,结论" > "$OUT"
log(){ echo "$(date '+%F %T'),$1,$2,$3,$4,$5" >> "$OUT"; }
# 链路状态
if ibstatus "$DEV" 2>/dev/null | grep -q "state: ACTIVE"; then
  log "链路状态" "ACTIVE" "ACTIVE" "state" "通过"
else
  log "链路状态" "ACTIVE" "DOWN" "state" "不通过"
fi
# 带宽测试(服务端后台起,客户端前台测)
bw_test(){
  local tool=$1 label=$2 dir=$3 th=$4 val
  ssh -f "$PEER" "$tool -d $DEV --report_gbits -s 65536 -q 4 >/tmp/srv_$$.log 2>&1"
  sleep 1
  val=$(timeout 30 $tool -d $DEV --report_gbits -s 65536 -q 4 "$PEER" 2>/dev/null | tail -1 | awk '{print $4}')
  if [ -z "$val" ]; then log "$label" "$dir $th" "NA" "Gb/s" "不通过"; return; fi
  if [ "$dir" = "gt" ]; then
    awk "BEGIN{exit !($val>=$th)}" && log "$label" ">=$th" "$val" "Gb/s" "通过" \
      || log "$label" ">=$th" "$val" "Gb/s" "不通过"
  fi
}
bw_test "ib_write_bw" "写带宽" gt "$TH_BW"
bw_test "ib_read_bw"  "读带宽" gt "$TH_BW"
# 延迟
lat=$(timeout 30 ib_send_lat -d "$DEV" -R "$PEER" 2>/dev/null | tail -1 | awk '{print $4}')
if [ -n "$lat" ]; then
  awk "BEGIN{exit !($lat<=$TH_LAT)}" && log "往返延迟" "<=$TH_LAT" "$lat" "us" "通过" \
    || log "往返延迟" "<=$TH_LAT" "$lat" "us" "不通过"
else
  log "往返延迟" "<=$TH_LAT" "NA" "us" "不通过"
fi
# GPUDirect(参考值,不卡阈值)
timeout 30 ib_write_bw -d "$DEV" --use_cuda "$PEER" >/dev/null 2>&1 \
  && log "GPUDirect RDMA" "可运行" "OK" "state" "通过" \
  || log "GPUDirect RDMA" "可运行" "FAIL" "state" "不通过"
# NCCL all_reduce(可选,传了节点列表才跑)
if [ -n "${3:-}" ] && command -v mpirun >/dev/null; then
  bw=$(mpirun -np 16 --allow-run-as-root -H "$(paste -sd, "$3")" \
        /usr/local/bin/all_reduce_perf -b 8 -e 128M -f 2 2>/dev/null | tail -1 | awk '{print $NF}')
  [ -n "$bw" ] && log "NCCL all_reduce" "busbw>0" "$bw" "GB/s" "通过" \
    || log "NCCL all_reduce" "busbw>0" "NA" "GB/s" "不通过"
fi
# PFC 暂停帧计数(参考)
pc=$(ethtool -S "$DEV" 2>/dev/null | awk -F: '/pause|pfc/{s+=$2} END{print s+0}')
log "PFC 暂停帧计数" "越低越好" "$pc" "cnt" "参考"
echo "已生成 $OUT"
📌 注意
mpirun的写法:-H后面跟的是逗号分隔的主机列表,不能用冒号嵌套(host1:host2:8这种写法是错的)。--allow-run-as-root是合法参数,别自己造一个--ipirun出来——前面那份报告就是这么翻车的。⚠️ 换 MPI 实现要换参数名:上面是 OpenMPI 的语法,主机列表用
-H host1,host2或-hostfile <文件>;如果集群装的是 Intel MPI,对应参数是-hosts,照抄 OpenMPI 的写法会直接报错。脚本发给别人之前,先问清对方用的是哪个 MPI 实现。
另外 5 个脚本#
| 脚本 | 平面 | 核心测试项 | 关键命令 |
|---|---|---|---|
business_network_test.sh | ② 业务管理网 | 连通性(100 包丢包率)、TCP 带宽、DNS、NFS 挂载与直写 | ping -c 100 / iperf3 -P 8 / dd oflag=direct |
bmc_network_test.sh | ③ 带外 BMC | IP 可达、chassis 可管理、传感器数量、SEL 可读 | ipmitool -I lanplus chassis status / sensor list / sel list |
ib_storage_network_test.sh | ④ IB 存储客户端 | IB 前端带宽、存储挂载、直写吞吐、并行 IO | ib_write_bw / dd oflag=direct / ior -a POSIX |
external_network_test.sh | ⑤ 外部出口 | 公网 HTTP、DNS、下载速率、22 端口应阻断 | curl -w %{http_code} / dig / nc -zv |
storage_backend_network_test.sh | ⑥ 存储内部 | 节点两两 IB 带宽、延迟、路由隔离 | ib_write_bw / ip route / ceph -s |
两个容易写错的地方:
BMC 口令必须走环境变量,不能写死在脚本里:
# 取值优先级:环境变量 IPMI_PASS → 第 3 个命令行参数 → 兜底示例值
PASS=${IPMI_PASS:-${3:-your_ipmi_password}}
批量自动化时口令统一从环境变量注入,不进脚本、也不落在别人可见的命令行历史里;临时手动跑一次,也可以直接把口令当参数传。
出口脚本的 22 端口判定是反的——能连上反而是不通过:
if nc -zv -w 3 8.8.8.8 22 2>&1 | grep -q succeeded; then
  log "出向22端口" "应阻断" "OPEN" "state" "不通过"
else
  log "出向22端口" "应阻断" "BLOCKED" "state" "通过"
fi
— — —
我从那份草稿报告里总结的 4 类硬伤#
前面说的那份报告,问题不止一处。我把常见的几类整理出来,你自己写报告的时候对照着看:
| 硬伤 | 现象 | 后果 |
|---|---|---|
| 状态列填数值 | “测试状态"列写 477.09 而不是"通过/失败” | 无法判断是否达标 |
| 命令写错造假数据 | -H 192.168.2.11:192.169.2.12:8 (参数错、IP 段错、冒号嵌套),结果却填了与别项相同的 773.79 GB/s | 复制粘贴的假数据,结论不可信 |
| 单位错位 | 测延迟填 3.0 us 写成别的单位 | 数据不可用 |
| 信息缺失 | Fabrics Manager 固件版本整列空白 | 无法做版本一致性核对 |
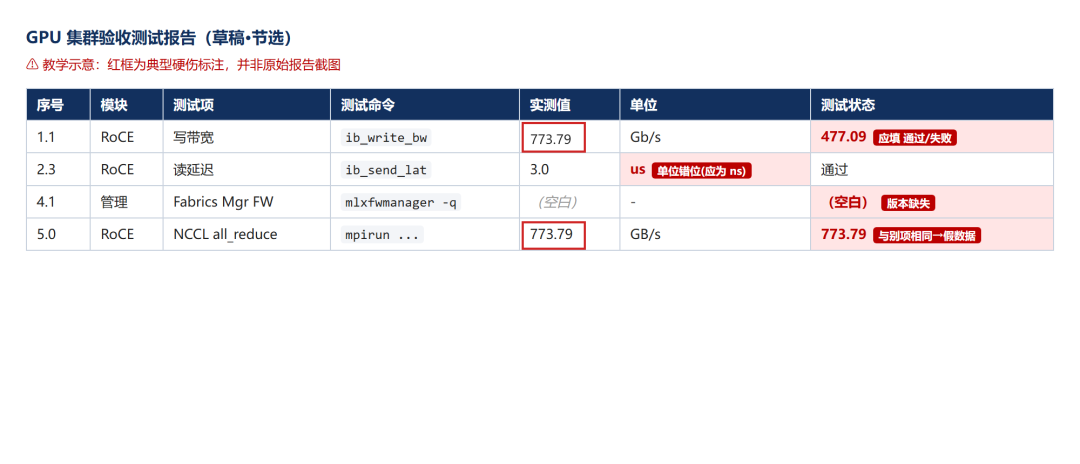
图:红框处两处实测值完全一致——不同工具、不同负载不可能跑出相同数值,这是复制粘贴最直接的证据。
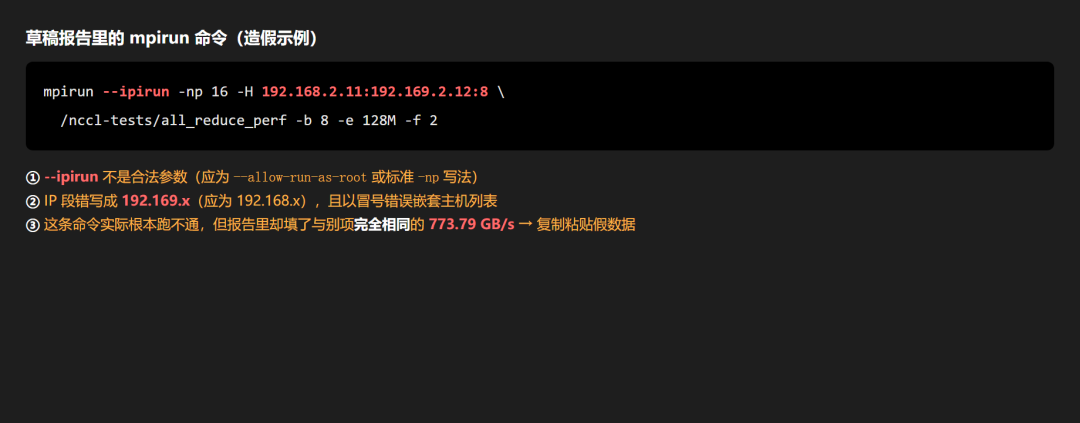
图:同一条命令三处问题——--ipirun 不是合法参数、IP 段写成 192.169.x、以冒号嵌套主机列表,实际根本跑不通
📌 闫工贴士:验收现场第二条铁律 —— 报告里不同负载下的两个测试项,实测值完全一致,99% 是复制粘贴造假。不同测试项跑的是不同工具、不同负载,数值从概率上就不可能一样。看到了就要求现场复测,别签字。
— — —
未达标项怎么闭环#
所有"不通过"项进这张表,复验通过才能关闭:
| 序号 | 发现时间 | 所属平面 | 问题类别 | 问题描述 | 严重等级 | 责任人 | 计划修复 | 当前状态 | 复验结果 |
|---|---|---|---|---|---|---|---|---|---|
| 1 | 09-02 | RoCE 计算网络 | 性能不达标 | 写带宽实测 477 Gb/s < 740 Gb/s | 高 | 责任人 A | 09-05 | 修复中 | — |
| 2 | 09-02 | 外部出口 | 连通性 | 软件源访问超时 | 中 | 责任人 B | 09-03 | 已修复 | 已复验通过 |
| 3 | 09-02 | 存储内部网络 | 性能 | 节点间带宽 150 Gb/s < 180 Gb/s | 高 | 责任人 C | 09-08 | 待修复 | — |
这张表粘进 Excel,给"当前状态"和"严重等级"加条件格式(红 = 待修复、黄 = 修复中、绿 = 已关闭),就是一张能直接给领导看的整改看板。
— — —
为什么这套东西值得抄?#
范围不漏
6 个平面一张清单,签字前逐项对,不会漏掉某一层
数据是真的
每条命令实际跑过、每个 CSV 带时间戳,经得起复查
顺序有讲究
先保带外,现场节奏不会因为一台机器卡死而崩盘
结论能闭环
三档结论 + 整改追踪表,“有条件通过"这一档给双方都留了余地
— — —
结尾#
你验收 GPU 集群的时候,有没有遇到过"报告交上去被打回"的情况?是漏了哪个平面,还是数据对不上?评论区说说,我看看能不能总结出几个高频翻车点。
关注【闫工的算力工具箱】,硬核实战经验,带你轻松避坑!
— — —
📖 推荐阅读
NAT 回流:内网通过公网 IP 访问内网服务失败的原因与配置
利旧 400G AOC / MPO 线缆 PRBS-31Q 双向验收与判定标准