📌 转载说明:本文首发于微信公众号《闫工的算力工具箱》 原文链接:https://mp.weixin.qq.com/s/1Ya0vLZISDZDOjngQyLA8Q
【闫工的工具箱 · 第 30 弹|硬件&GPU】#
我是闫工,数据中心搬砖的 CCIE。
今年被问得最多的一个问题:B300 到底怎么样。
客户算要不要上,领导算要不要买,机房算功率够不够——都指向同一件事:这台机器真跑起来是个什么数。datasheet 上的数是厂商给的,不是跑出来的。
我自己没接触过 B300,这句话先说在前面。所以这篇的写法跟平时不太一样:底下这些数不是我测的,是我从一份公开的真机实测笔记里扒出来的,按运维角度重新排了一遍。
出处得先交代清楚,这事儿不能含糊。
— — —
数据是哪来的#
笔记是 Hitesh Kumar 在 2026 年 1 月发在 Substack 上的《B300 Field Notes》。他手上有台裸金属 B300 HGX 节点,把 NCCL-tests、NVBandwidth、DCGM 那套全跑了一遍。
我不是原作者,也没碰过他那台机器。这篇里凡是带「实测」字样的数,出处都是那份笔记;凡是「我会盯」「对机房意味着」的,是我自己总结的话。别人测的数就是别人测的,署清楚,谁都不吃亏——这些数背后,是别人花时间跑出来的。
| 组件 | 版本 |
|---|---|
| NVIDIA Driver | 580.95.05 |
| CUDA | 13.0 |
| DCGM | 4.4.1 |
| NCCL-tests | 2.17.6 |
| NVBandwidth | 0.8 |
这张版本表我特意放在最前面,因为它比后面那些数还重要:DCGM 是从 4.4.0 才开始声明支持 B300 的。 你要是拿老版本 DCGM 去测 B300,跑出来的数不可信,别拿着去跟人对线。这条我吃过亏,早年用不匹配的工具版本测过一批卡,数据漂得莫名其妙,最后查下来是工具根本不认那代硬件。
— — —
先看清这台机器是什么底子#
B300 的官方 datasheet 到现在还有些前后不一致的地方,下面这几个是多方信息对出来的,也是跟机房直接相关的几项:
- 显存 288 GB HBM3E,聚合带宽 8 TB/s,8 个 12-Hi 堆栈、每栈 36 GB;
- TDP 常规 1100 W,风冷和液冷两种 SKU 都是这个数,部分版本能到 1200 W,塞进 GB300 tray 里的那颗可以顶到 1400 W;
- NVLink 第五代,每 GPU 双向 1.8 TB/s,18 个 100 GB/s 端口;
- Scale-out 每 GPU 一个 OSFP 笼子接 ConnectX-8 SuperNIC,800 GB/s 全双工,GPU 到 NIC 之间走 PCIe Gen6 x16。
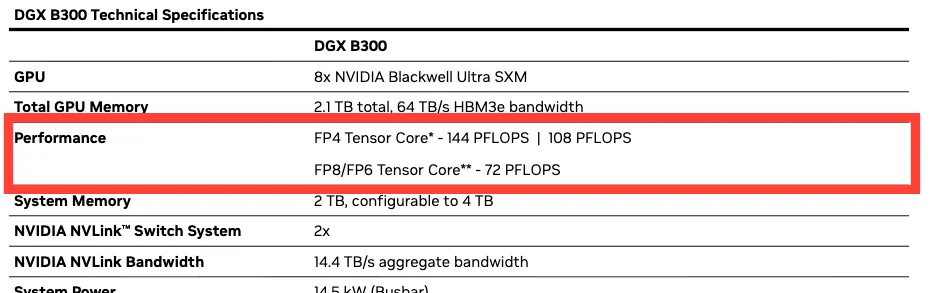
图:DGX B300 官方技术规格表,红框那行是 Performance(来源:NVIDIA 公开资料)
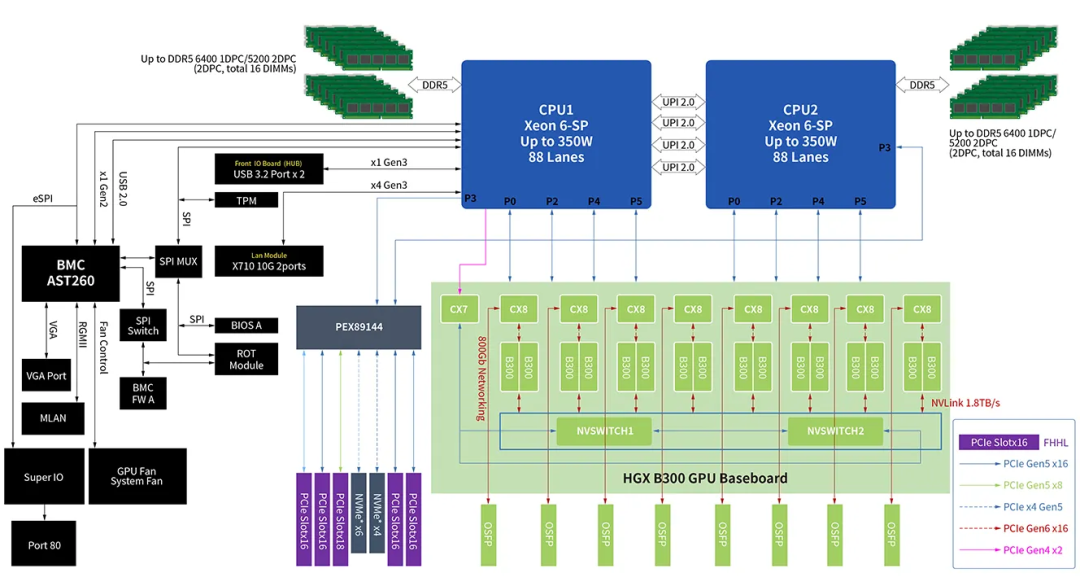
图:HGX B300 系统框图,能看清双 Xeon 6-SP、8 颗 B300、NVSwitch 与 CX8 SuperNIC 的互联关系(来源:ASUS 公开资料)
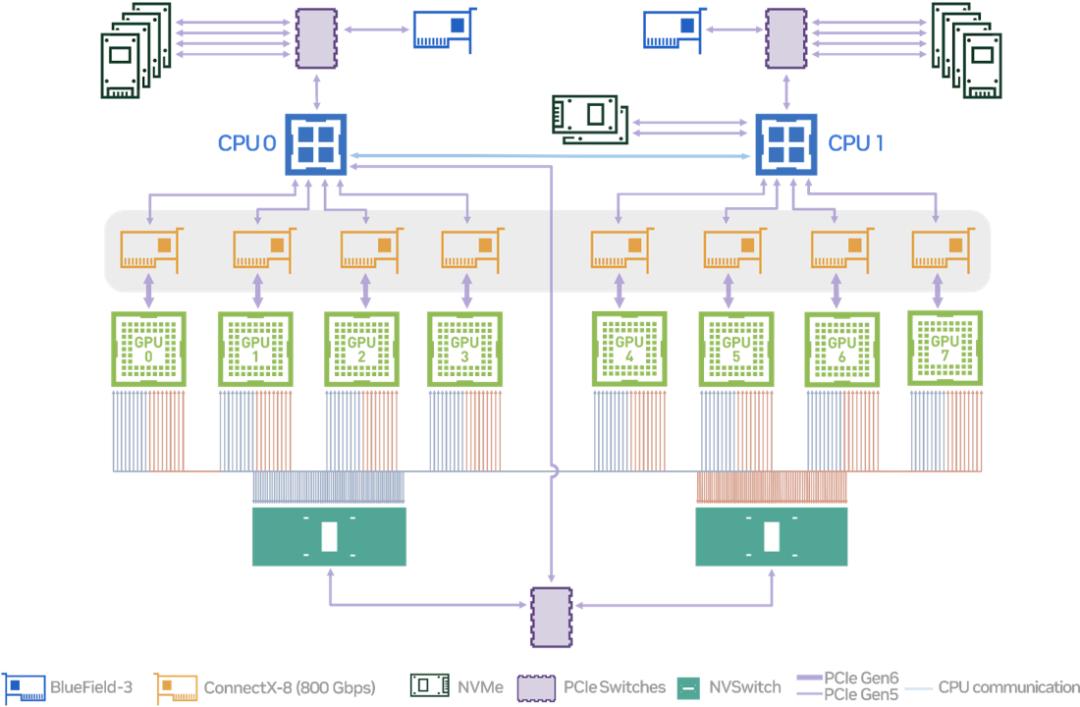
图:DGX B300 官方系统拓扑(来源:NVIDIA 公开资料)
看框图有个好处:你能提前知道这台机器插上去之后,网络那头要接什么。 CX8 SuperNIC 走 OSFP 笼子、800 GB/s 全双工,意味着你机房如果还按 200G 那一套备光模块和线缆,到货那天就得抓瞎。这种事我见过不止一次,机器到了,线不够,或者模块速率对不上,一个上架窗口就废了。
— — —
六个我盯住的数#
原笔记里数据很多,我挑了六个。挑选标准就一条:这六个会改变我的运维决策,剩下的要么太细,要么暂时用不上。
数一:837 GB/s,漂亮,但同一次测试里 broadcast 只有 682#
NCCL all-reduce 峰值带宽跑到了约 837 GB/s,是理论峰值 900 GB/s 的 93%。这个比例相当好看,说明 8 卡之间的 NVLink 域是健康的,没有哪条链路拖后腿。
但同一份测试里,broadcast 只跑到约 682 GB/s,是峰值的 76%。
这两个数放一起看才有意思。all-reduce 是所有卡都参与、数据在各卡之间归约,走的路径对称;broadcast 是一张卡往其他所有卡扇出,根部那张卡的出向就成了瓶颈。76% 不是故障,是这个操作本身的形状决定的。
我对这个数的态度是:别只记那个最好看的。你做验收的时候如果只跑 all-reduce 看一眼 837 就签字,等于只验了一半。真正训练里的通信模式比这复杂得多,all-to-all 那条链路在小消息下延迟能到 68 µs,比 all-reduce 的 42–52 µs 高出一截。
📌 我的验收习惯是:all-reduce 和 all-to-all 都跑,两个都留基线。 只留一个,将来对不上数的时候你没法判断是网络退化还是本来就那样。
数二:H2D 38 GB/s 对 D2H 53 GB/s,差了快四成#
NVBandwidth 里最扎眼的一个不对称:主机往卡里拷数据(H2D)约 38 GB/s,卡往主机拷(D2H)约 53 GB/s。理论峰值 64 GB/s(PCIe Gen5 x16 单向),前者只跑到 59%,后者跑到 83%。
原因在发起方不一样:
- D2H 是 GPU 的 copy engine 主动发起 PCIe read,CPU 基本只被动提供内存带宽和一致性,DMA 容易跑满,所以接近峰值;
- H2D 是 CPU 主动写,要处理 cache coherence、write-combining buffer、DRAM controller 协调,多路 CPU 还叠一层 NUMA 远程内存延迟,多卡并发时 CPU 内存带宽先撑不住。
这个不对称通常不是瓶颈——训练和推理里绝大多数流量是卡到卡(D2D),主机侧那点流量主要是控制指令、初始化、checkpoint 和数据加载。
但有个例外:你要是做高频 checkpoint,或者数据加载全压在 CPU 侧,这个口子就会咬人。 我见过训练跑得好好的,一到保存 checkpoint 就卡半天,查下来不是盘慢,是主机往卡里塞得慢。
顺带说一句,D2D 那组数反而很漂亮:单向读约 782 GB/s、写约 717 GB/s,双向能到 1.35 / 1.41 TB/s。这才是 B300 真正卖力气的地方。
数三:130 W。B300 闲着也在烧电,而且是 H100 的 1.86 倍#
这个数是我看完最上心的一个。
B300 空闲功耗约 130 W/卡,占 1100 W 峰值的 11.8%,那时 GPU 温度才 17 °C。对照 H100:空闲约 70 W,占 700 W 峰值的 10%,温度 27 °C。
绝对功耗差了 1.86 倍,峰值功耗才差 1.57 倍。也就是说,闲着的时候,B300 比 H100 更能吃。
有人可能会说温度更低漏电应该更小。这话没错,但那是同温度对比;实际机房里 B300 就是跑在 17 °C,而且固件和驱动对空闲功耗的影响往往比环境温度更大。
对机房来说这件事很实在:
- 如果你按固定电力预算把 H100 全换成 B300(总功率不变),空闲电费是要涨的,定价得重新算一遍;
- 如果你按固定性能需求用更少的 B300 去替 H100,那至少得把卡数降到原来的三分之一,空闲功耗才会明显下来;峰值能效(FLOPs/W 或 tokens/W)反而更容易做上去。
⚠️ 这段是我自己的推论,不是笔记里的原文。笔记只给了两个空闲功耗的读数,怎么算账是机房自己的事。但你要是正准备做 B300 替换 H100 的方案,这个账现在就得算,别等电费单出来。
所以真要做替换,闲时电费这笔账得先算清楚,别做无用功。
等电费单出来再回头补,就晚了。
数四:950 W。标称 1100 W,压测最多只跑到 86%#
DCGM L3 压测里,最高读数约 950 W/GPU,占额定 1100 W 的 86%。那剩下的 150 W 去哪了?HPL 和 gpu_burn 这类更重的负载,能让 B300 顶到 1100 W。DCGM 的 L3/L4 压测,并不是这颗卡能吃到的最重负载。
这条对机房的意义是反过来的:你不能因为压测只有 950 W,就把机柜功率预算按 950 W 算。 供电和散热设计按 1100 W/卡做,留的那点余量是给你兜底的,不是给你省钱用的。
我在机房里定功率预算,一律按 TDP 上限走,从不按实测均值走。实测均值是「一般会这样」,TDP 是「最坏会那样」,机房设计只能信后者——这背后全是实打实的功耗。
真实推理负载下的持续功耗,笔记里提到一个传闻:H100 SXM 在真实推理中通常不超过峰值的 50–60%。B300 单卡就能放下 70B 模型,多卡并行的策略会变,通信瓶颈也会少一截——这些都会影响绝对功耗和每瓦性能。这部分光看规格表估不出来,得真跑一遍才知道。
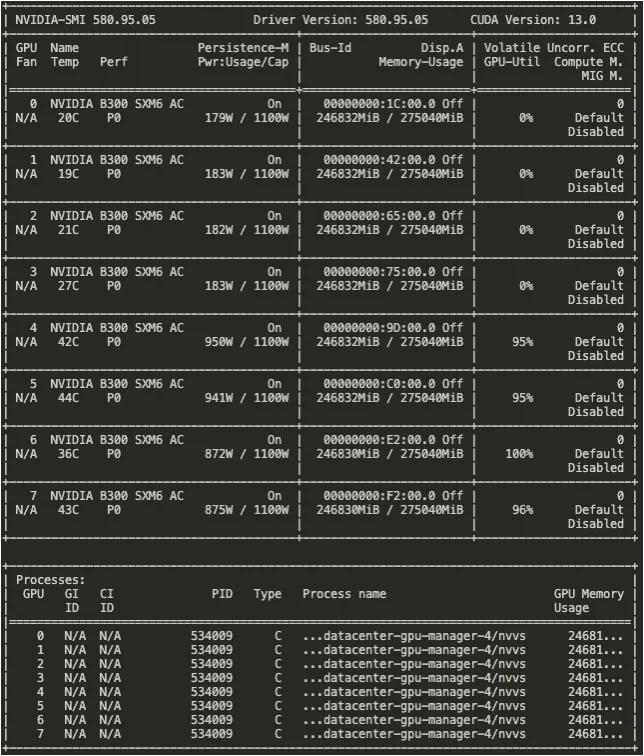
图:原作者在同一台机器上跑 nvidia-smi 时的读数,8 张 B300 功耗从 179 W 到 950 W 不等,显存占用约 24683 / 275040 MiB(来源:Hitesh Kumar 2026 年 1 月 Substack 笔记,已标注)
数五:288 GB 只认到 284 GB#
DCGM 显示可分配显存约 284 GB,占 288 GB 的 98.6%。剩下的那点被保留区域、驱动开销、ECC 吃掉了。
这个数看着不起眼,但它是那种你算得越紧越容易翻车的东西。
比如你要判断一个 70B 模型能不能塞进单卡,显存预算是掐着算的:权重、KV cache、激活值、框架自己的开销,一项项加起来。这时候你按 288 GB 算还是按 284 GB 算,差的这 4 GB 有时候就是"能跑"和"OOM"的区别。
我现在的做法很土但管用:做显存预算一律按 DCGM 给的可分配值算,不按标称算。 标称是给你看规格用的,可分配值才是你能真拿到的,别管标称多漂亮,拿到手的才算实。
数六:1.4 µs 对 4.0–5.4 µs,两个工具差了三倍,谁是对的#
这个数最容易被拿来互相打脸。
NVBandwidth 测出来的 H2D/D2H 延迟约 1.4 µs,D2D 约 1.6 µs。DCGM 测出来的 H2D 是 4.0–5.4 µs,D2H 是 3.9–4.9 µs,双向 4.8–6.7 µs。
差了三倍,两个都没错。因为测的根本不是一回事:
NVBandwidth 测的是 GPU 侧。 从 GPU 的 memcpy kernel 或 DMA 引擎启动,到 PCIe / NVLink 事务完成为止,把主机侧的软件开销全排除掉。这是把 DMA 事务延迟单独隔离出来看。
DCGM 测的是端到端完整往返。 里面除了那 1.4 µs 的纯 DMA,还叠了 CPU 调度抖动、CUDA driver call 开销(几百纳秒到 1 µs)、kernel / DMA 启动延迟、GPU 完成信号与中断、CPU 轮询等待(cudaDeviceSynchronize() 那类阻塞调用)、CUDA 调用返回开销。
所以结论是这样的:NVBandwidth 的数更适合验证链路本身健不健康,DCGM 的数更接近应用实际感受到的延迟。 排障的时候别拿两个工具的读数互相否定,那是在跟自己过不去。
我的用法是先用 NVBandwidth 定链路基线(这根线本来该是多少),再用 DCGM 看应用实际体验(现在是多少),两头一比,问题在硬件还是在软件栈就清楚了。
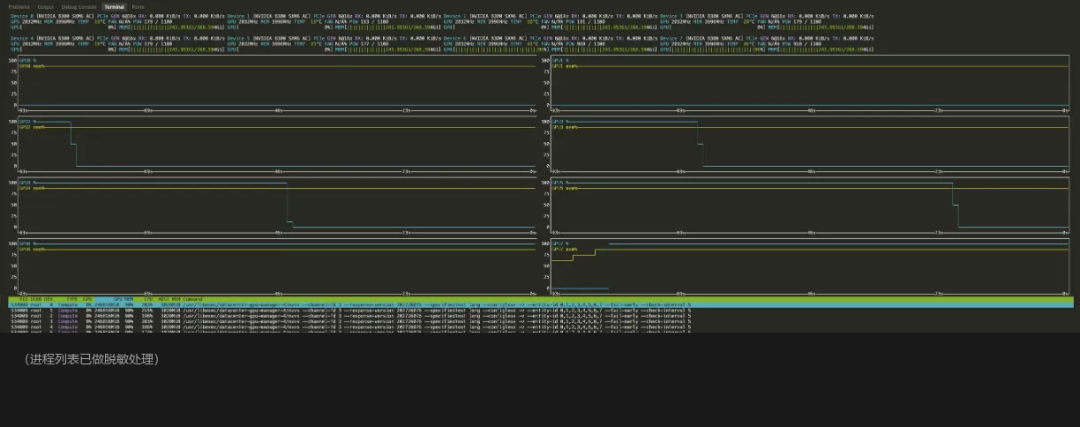
图:原作者用 nvtop 做的 8 卡监控截图,曲线能直观看到各卡负载是否同步;底部进程列表已做脱敏处理(来源:Hitesh Kumar 2026 年 1 月 Substack 笔记,已标注)
— — —
还有几个没验证的,我标出来#
笔记里有两条原作者明说了自己没复现,我也照实标:
- HPL-MxP 整机可达 1.5–1.7 PFLOPS,作者没跑过;
- HBM 真实带宽,作者没实测。NVIDIA 标称 8 TB/s,多方推算理论能到 9.4–9.8 TB/s,很可能是为功耗和散热降额到了 8。作者估计优化到极致也很难超过 7 TB/s,多数负载更接近 6 TB/s。
这两条我不当结论用,只当待验项记着。哪天真摸到机器,这是第一批要跑的。
— — —
如果真要上 B300,我会盯这四件事#
把上面的数收一收,落到机房里是四件具体的事:
一、机柜功率按 1100 W/卡 算。 别看压测只有 950 W 就省下来,HPL 和 gpu_burn 能顶满。GB300 tray 里的那颗更是 1400 W。
二、软件版本先对齐再测。 Driver 580.95.05、CUDA 13.0、DCGM 4.4.1 起、NCCL-tests 2.17.6。尤其 DCGM,4.4.0 之前不支持 B300,版本不对测出来的数全是假的。
三、到货先留基线。 nccl-tests 和 nvbandwidth 各跑一遍,all-reduce 和 all-to-all 都留,跟这份笔记里的数(837 GB/s、1.4 µs)横向对一下。对不上别急着报障,先查工具版本和链路状态,NVLink 掉一条 lane 就能让带宽掉一截。
四、光模块和线缆提前备。 800 GB/s 全双工走 OSFP 笼子,跟 200G 那套不是一回事。机器到了才发现线不对,一个上架窗口就没了。
📌 顺便说个省事的办法:单块卡或者单台机器的体检流程,我写过一套完整的现场诊断工作流,在第 20 弹NVIDIA Field Diagnostic 完整工作流:GPU 报障与 RMA 前的硬件体检;真出问题要收日志交 RMA,第 27 弹那个脚本一条命令就能收齐GPU 掉卡要交日志,我受够了手敲命令:写了个脚本一键收。这两篇和这篇是配套的,出问题的时候按 20 → 27 这个顺序走。
— — —
结尾 · 互动#
B300 我到现在还没亲手摸过,这篇是拿别人的实测加上我自己的运维账拼出来的。有接触过的兄弟,可以在评论区聊聊——特别是空闲功耗那块,你那边实测是不是也在这个量级?评论区报个数,一起对个实测。
还有个问题想问:你们机房做 GPU 机柜功率预算,是按 TDP 上限走,还是按实测均值走?我一直是按上限——按均值算,早晚要被电费单教育一次。

推荐阅读:官网TFLOPS写312实测67:算力"虚标"的锅,可能不在你的GPU
一台台登 BMC 改配置,我改用 Redfish API 批量下发
关注【闫工的算力工具箱】,分享机房一线硬核实战经验,带你在运维交付路上少踩没必要的坑。